Exploratoryとは?
Exploratoryは、アナリストやビジネスユーザーが、データの加工、可視化、統計分析、機械学習、AIを、直感的なグラフィカル・インターフェースを通して行うことができるデータサイエンス・プラットフォームです。
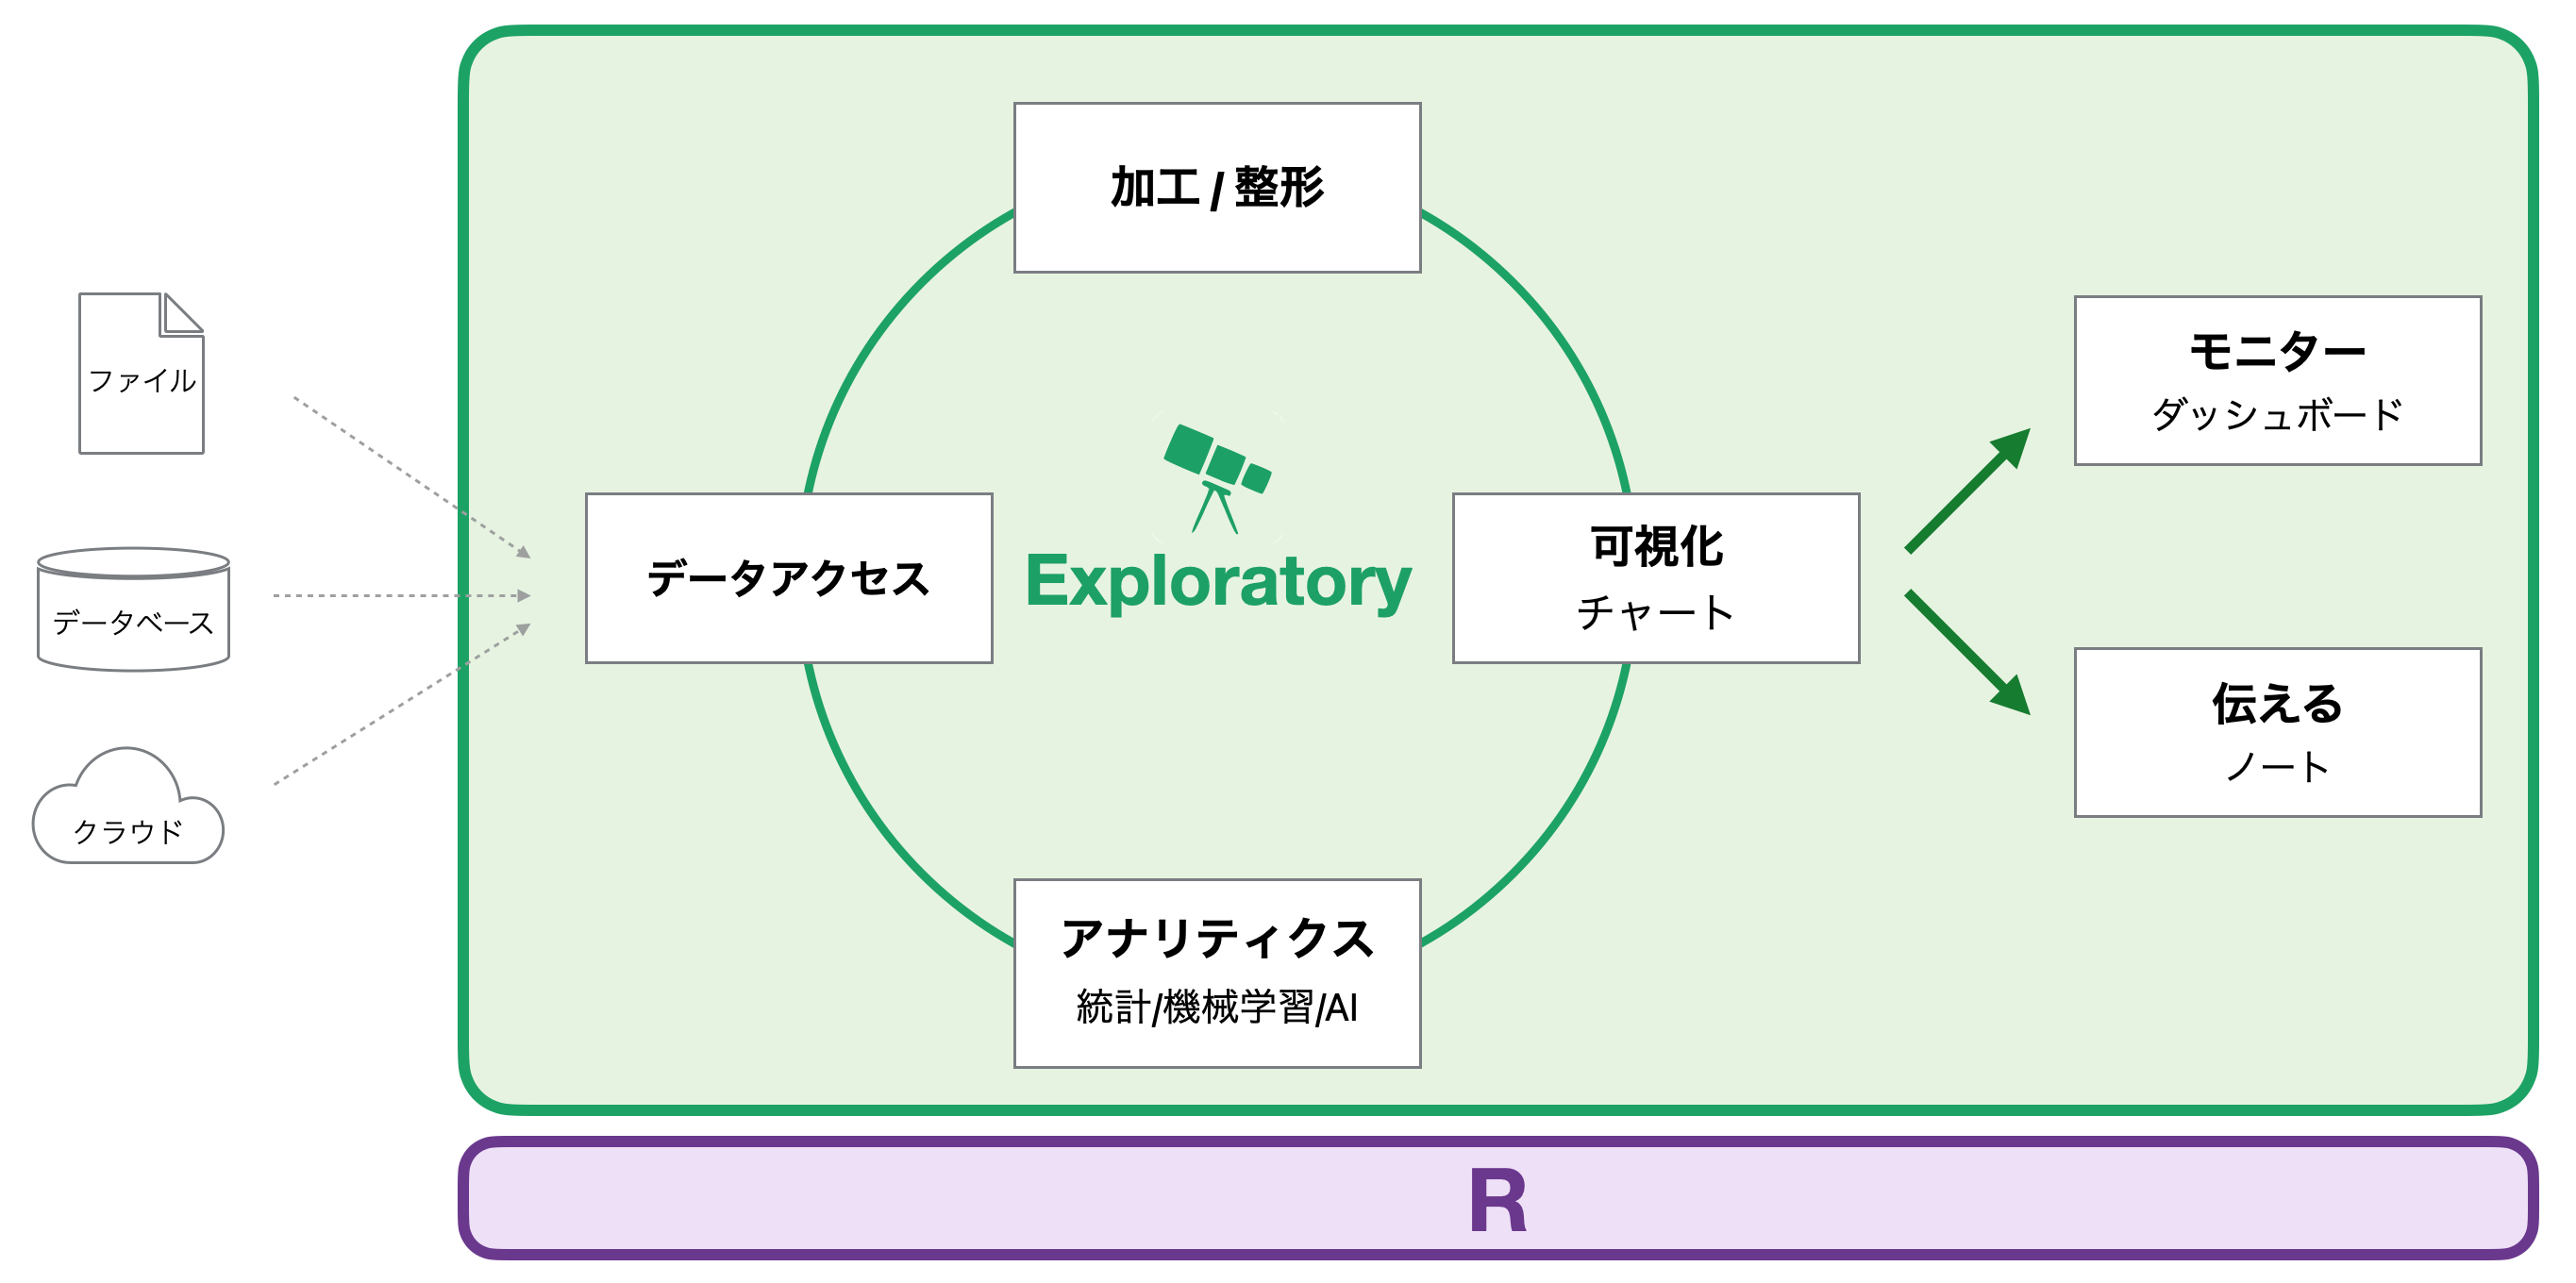
Exploratoryの分析エンジンには、オープンソースの統計解析環境であるRが使われています。そのため、Rが持つ強力なデータ加工や統計分析の能力を活用しながら、多くの分析作業をコードを書くことなく進めることができます。
データを取り込んで終わりでも、チャートを作って終わりでもありません。
データの取得から、加工、探索、可視化、統計分析、機械学習、そして分析結果の共有までを、1つの再利用可能なワークフローとして管理できることがExploratoryの特徴です。
Exploratoryで何ができるのか?
データ分析の仕事では、実際に統計分析をしたり、機械学習の予測モデルを作ったりする時間よりも、その前後の作業に多くの時間がかかります。
データを集める、不要な行を除く、複数のファイルを結合する、計算列を作る、集計する、チャート(グラフ)を作る、分析する、そして結果を共有する。
Exploratoryでは、こうした一連の作業を同じ環境の中で進めることができます。
データに接続する
Exploratoryでは、CSVやExcelなどのファイルだけでなく、データベースやクラウドサービス、APIなど、さまざまなデータソースからデータを取り込むことができます。
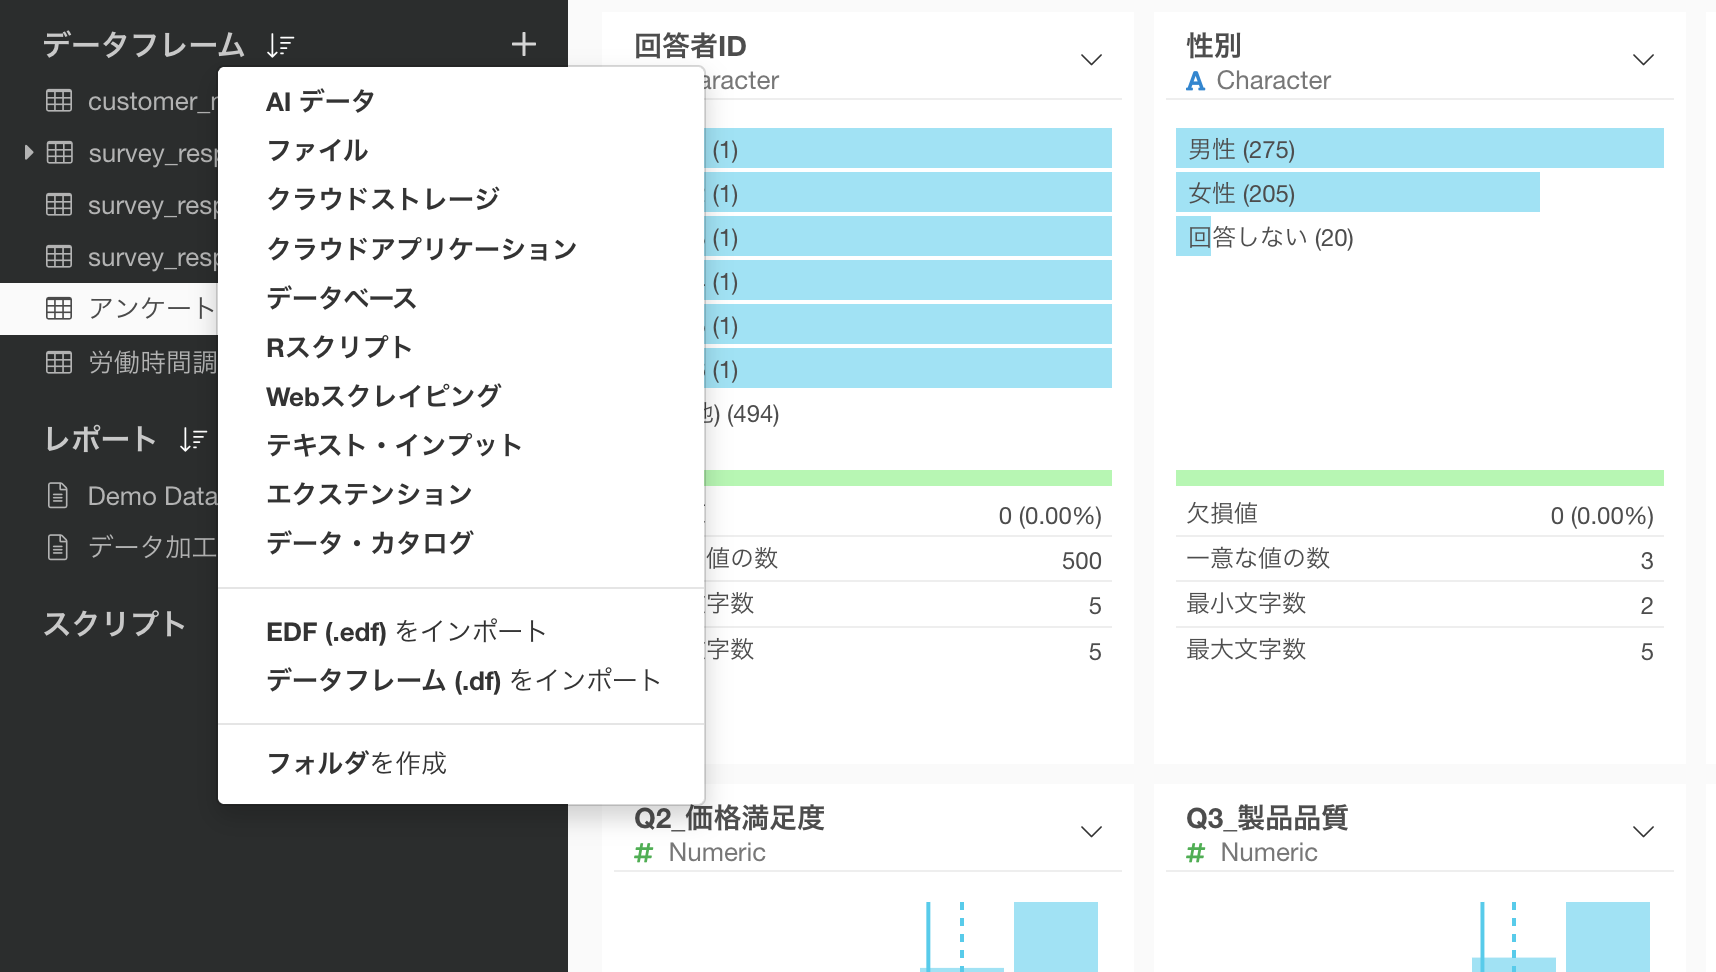
Rからアクセスできるデータソースであれば、必要に応じてRスクリプトを利用して取り込むこともできます。
そのため、分析を始めるために毎回別のツールでデータを準備してからExploratoryに持ち込む必要はありません。
複数の場所にあるデータを集め、1つの分析ワークフローの中に簡単に取り組むことができます。
データを加工する
実際のデータ分析では、データ分析にかかる時間の6割から8割はデータ加工だとよく言われます。
Exploratoryでは、例えば以下のような加工をグラフィカルなインターフェースから行うことができます。
- 条件に合わせて行を絞り込む
- 複数のデータを結合する
- グループごとに集計する
- 列と行を入れ替える
- 新しい計算列を作る
- 欠損値を処理する
- 日付や文字列を加工する
- アンケートデータを分析しやすい形に変換する
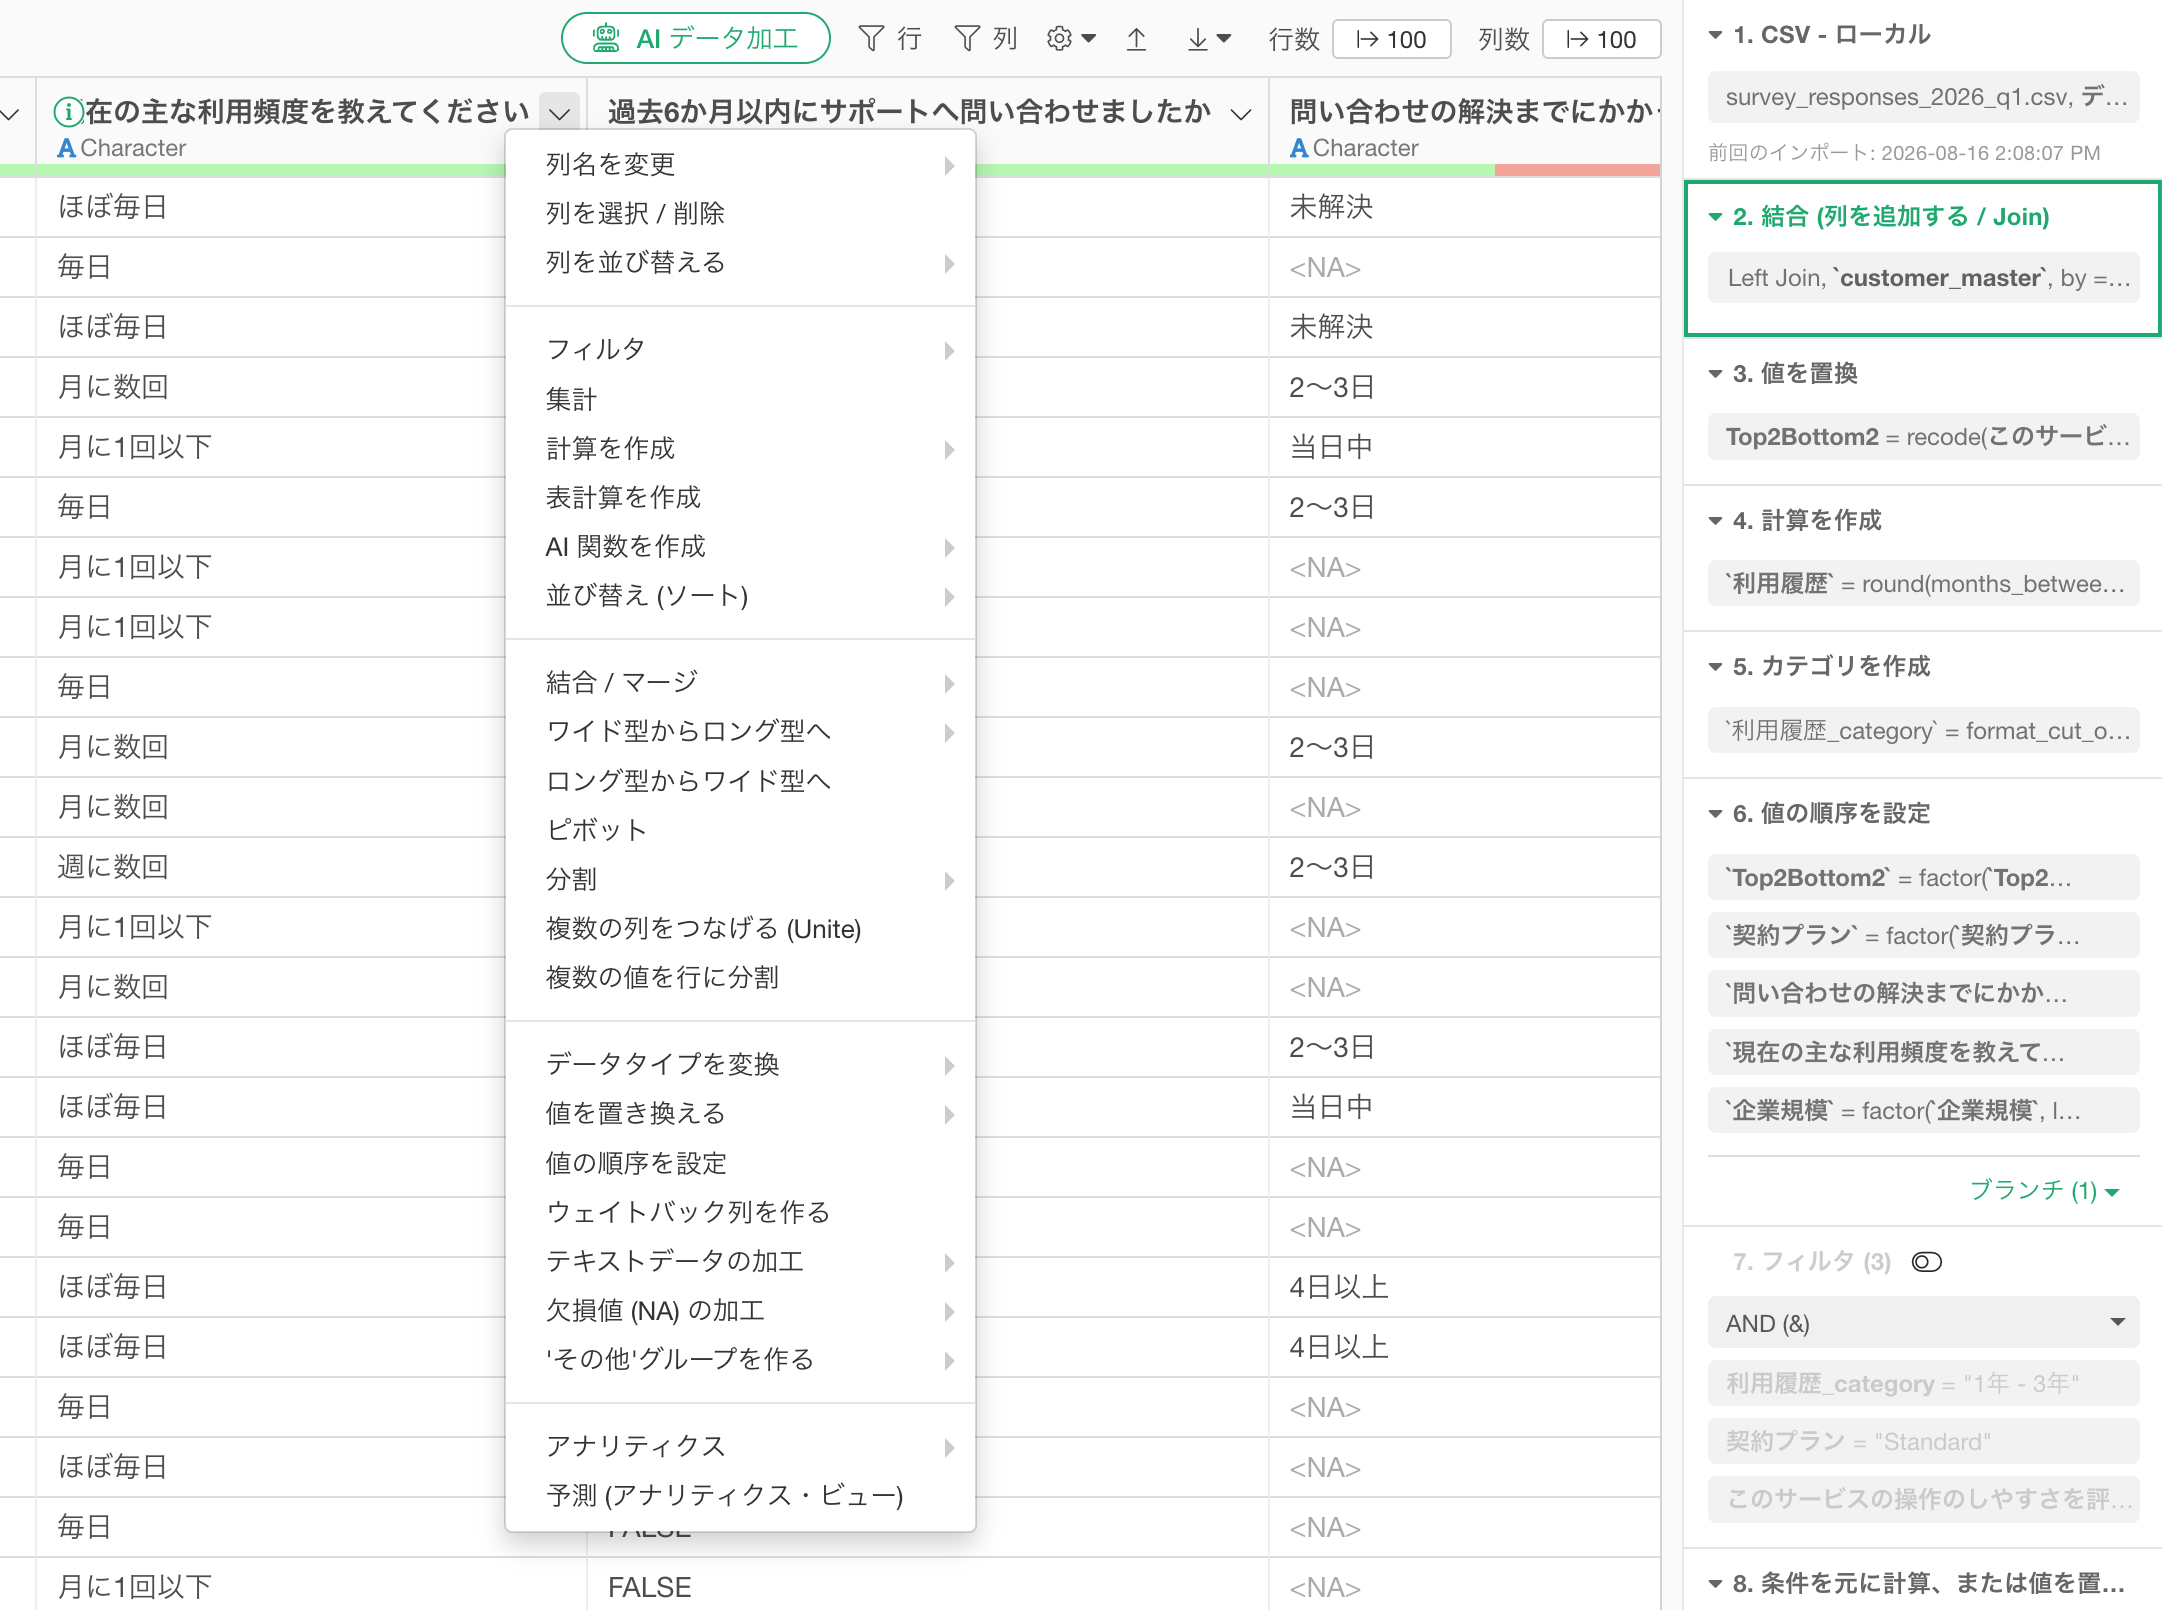
重要なのは、こうした加工が単発の操作として終わらないことです。
Exploratoryでは、それぞれの加工がステップとして記録されます。
そのため、元のデータが更新された場合でも、同じ加工を最初から手作業で繰り返す必要はありません。保存されたステップを新しいデータに対して再実行することができます。
データを探索し、可視化する
データの特徴を理解するためには、平均値や合計値を見るだけでは十分ではありません。
値がどのように分布しているのか、グループ間に違いがあるのか、変数同士に関係があるのか、時間とともにどのように変化しているのか、といったことを探索していく必要があります。
Exploratoryでは、さまざまなチャートやピボットテーブルを使ってデータを視覚的に探索することができます。
例えば、
- 棒グラフ
- 折れ線グラフ
- 散布図
- ヒストグラム
- 箱ひげ図
- 地図
- ピボットテーブル
などを使いながら、データの分布や傾向、グループ間の違い、変数間の関係を確認できます。
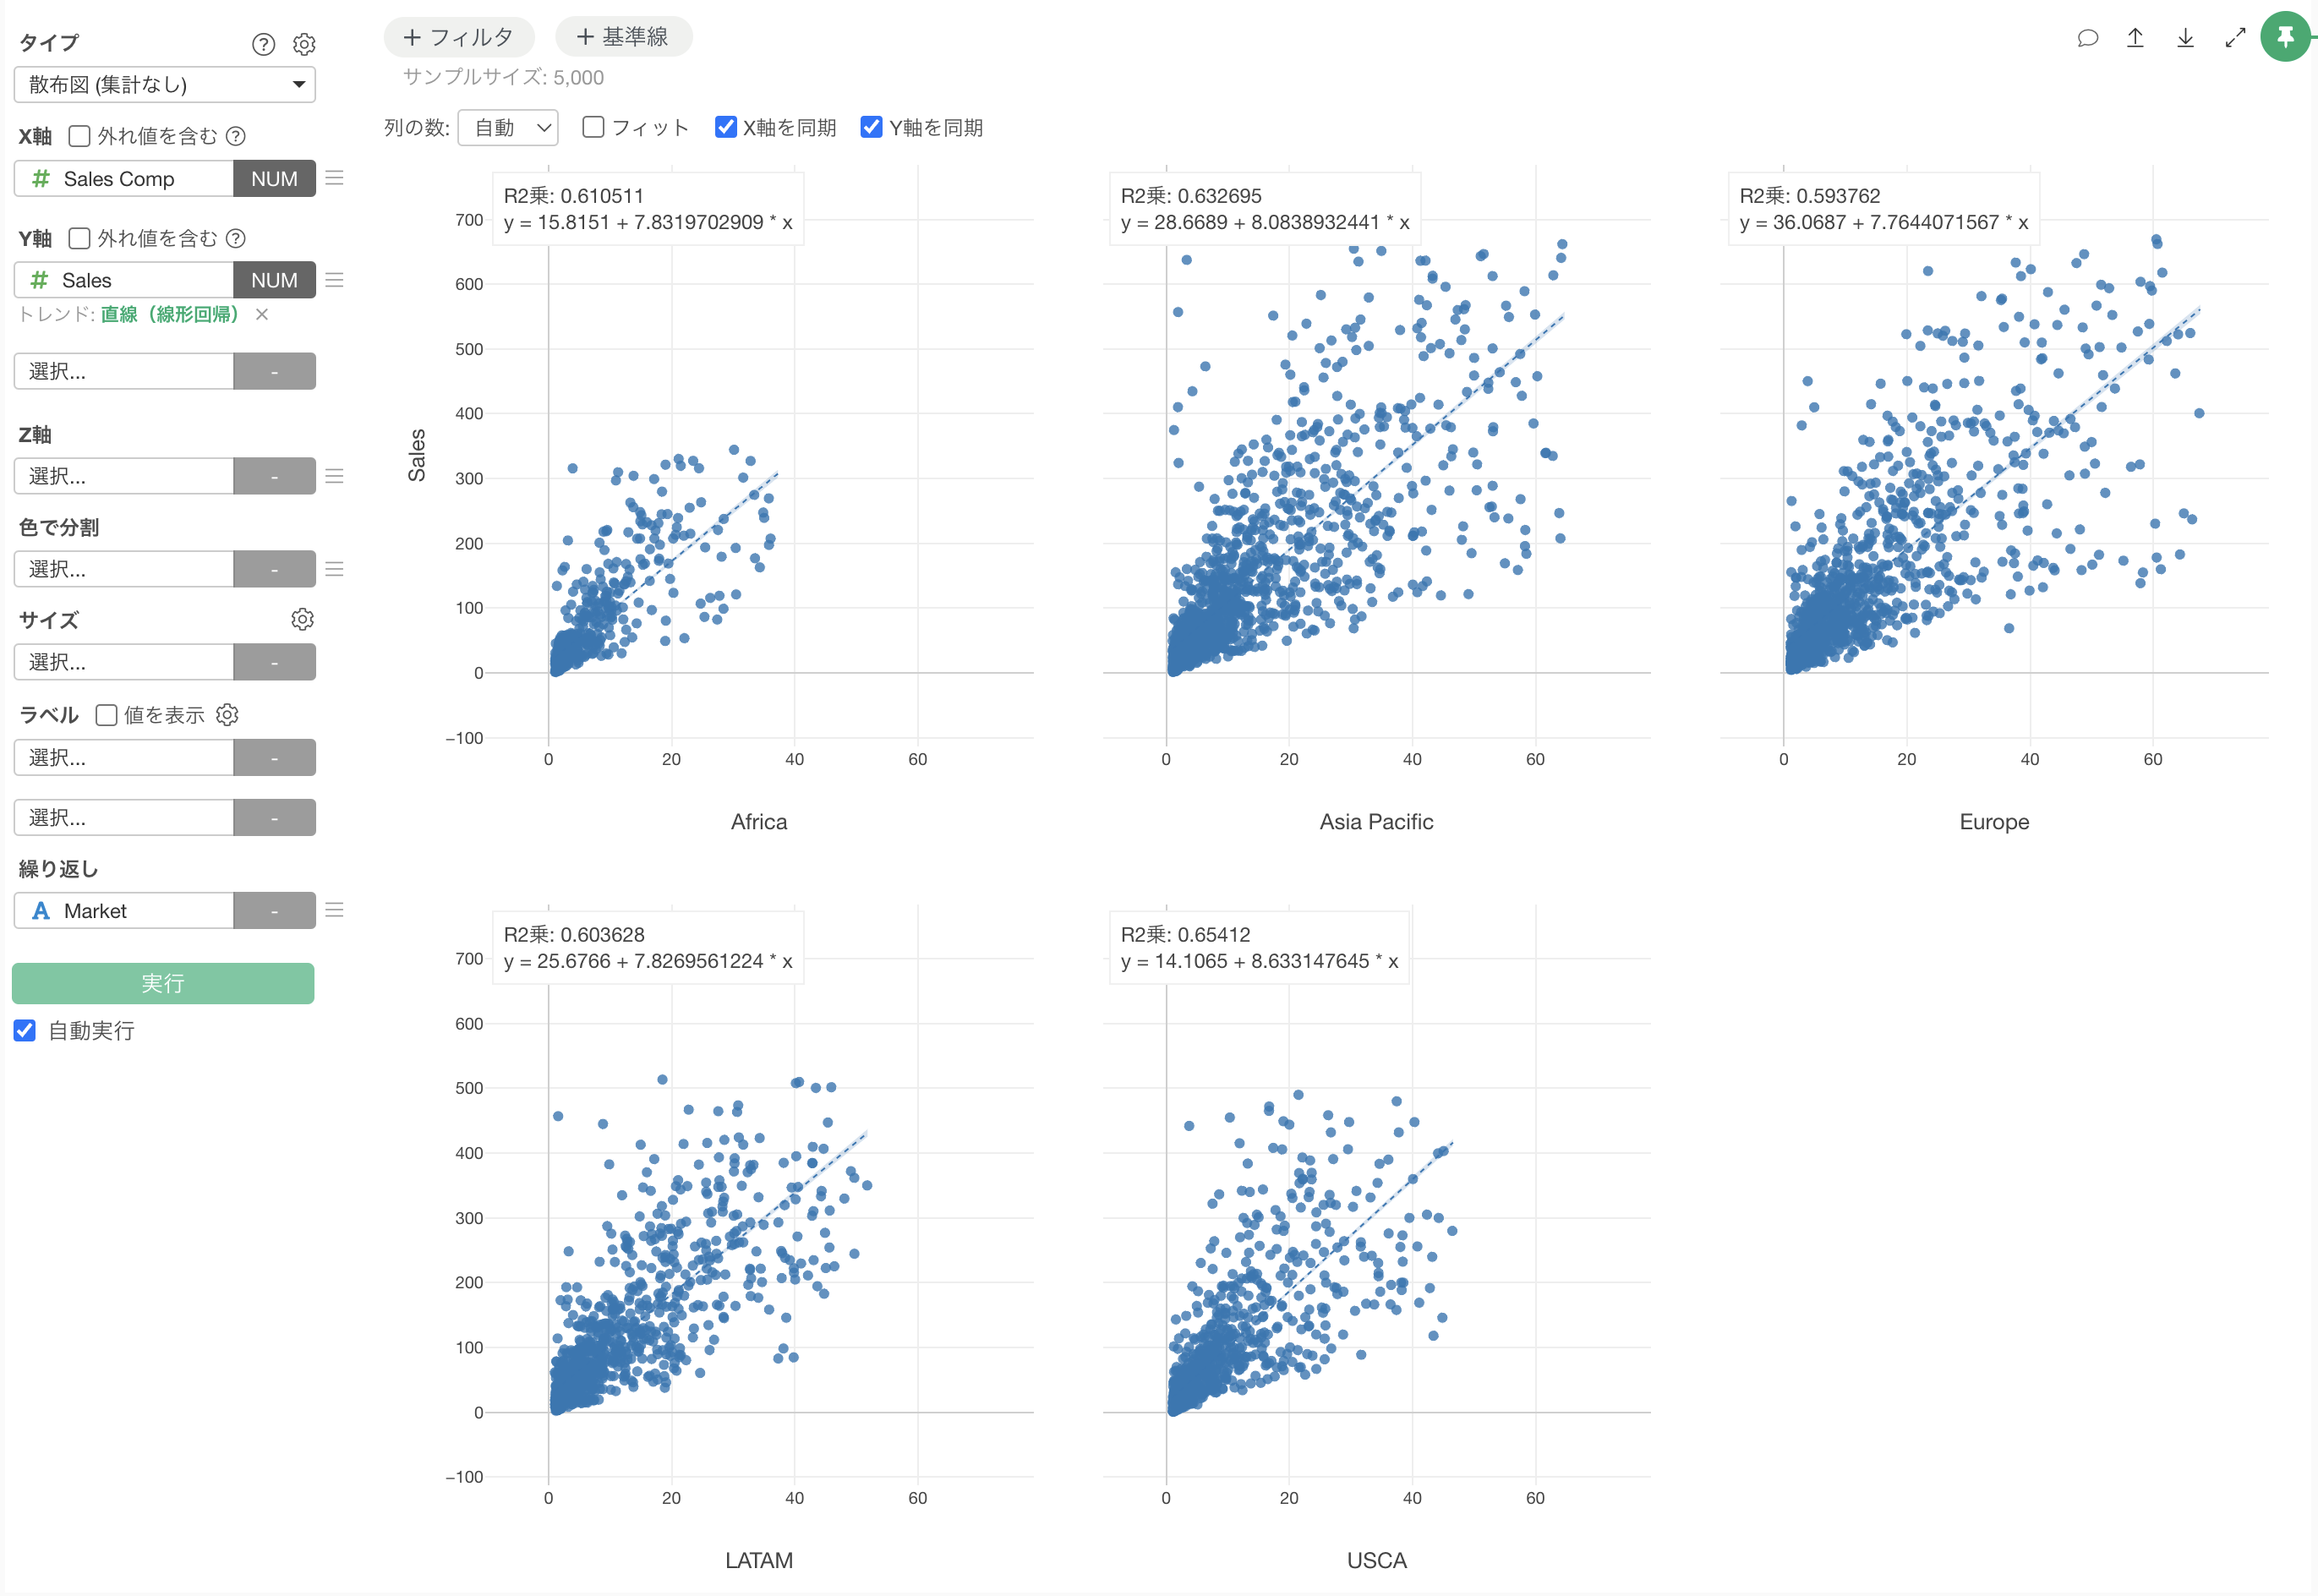
さらに、可視化とデータ加工、統計分析が同じワークフローに統合されているため、チャートを見て気になった点をすぐに加工や分析へつなげていくことができます。
統計分析と機械学習を使って、データをより深く理解する
データを可視化することで多くのことが分かります。
一方で、
「この違いは偶然なのか」
「どの要因が結果に影響しているのか」
「どのようなグループに分かれているのか」
「将来どのような結果になる可能性が高いのか」
といった問いに答えるためには、統計分析や機械学習が必要になります。
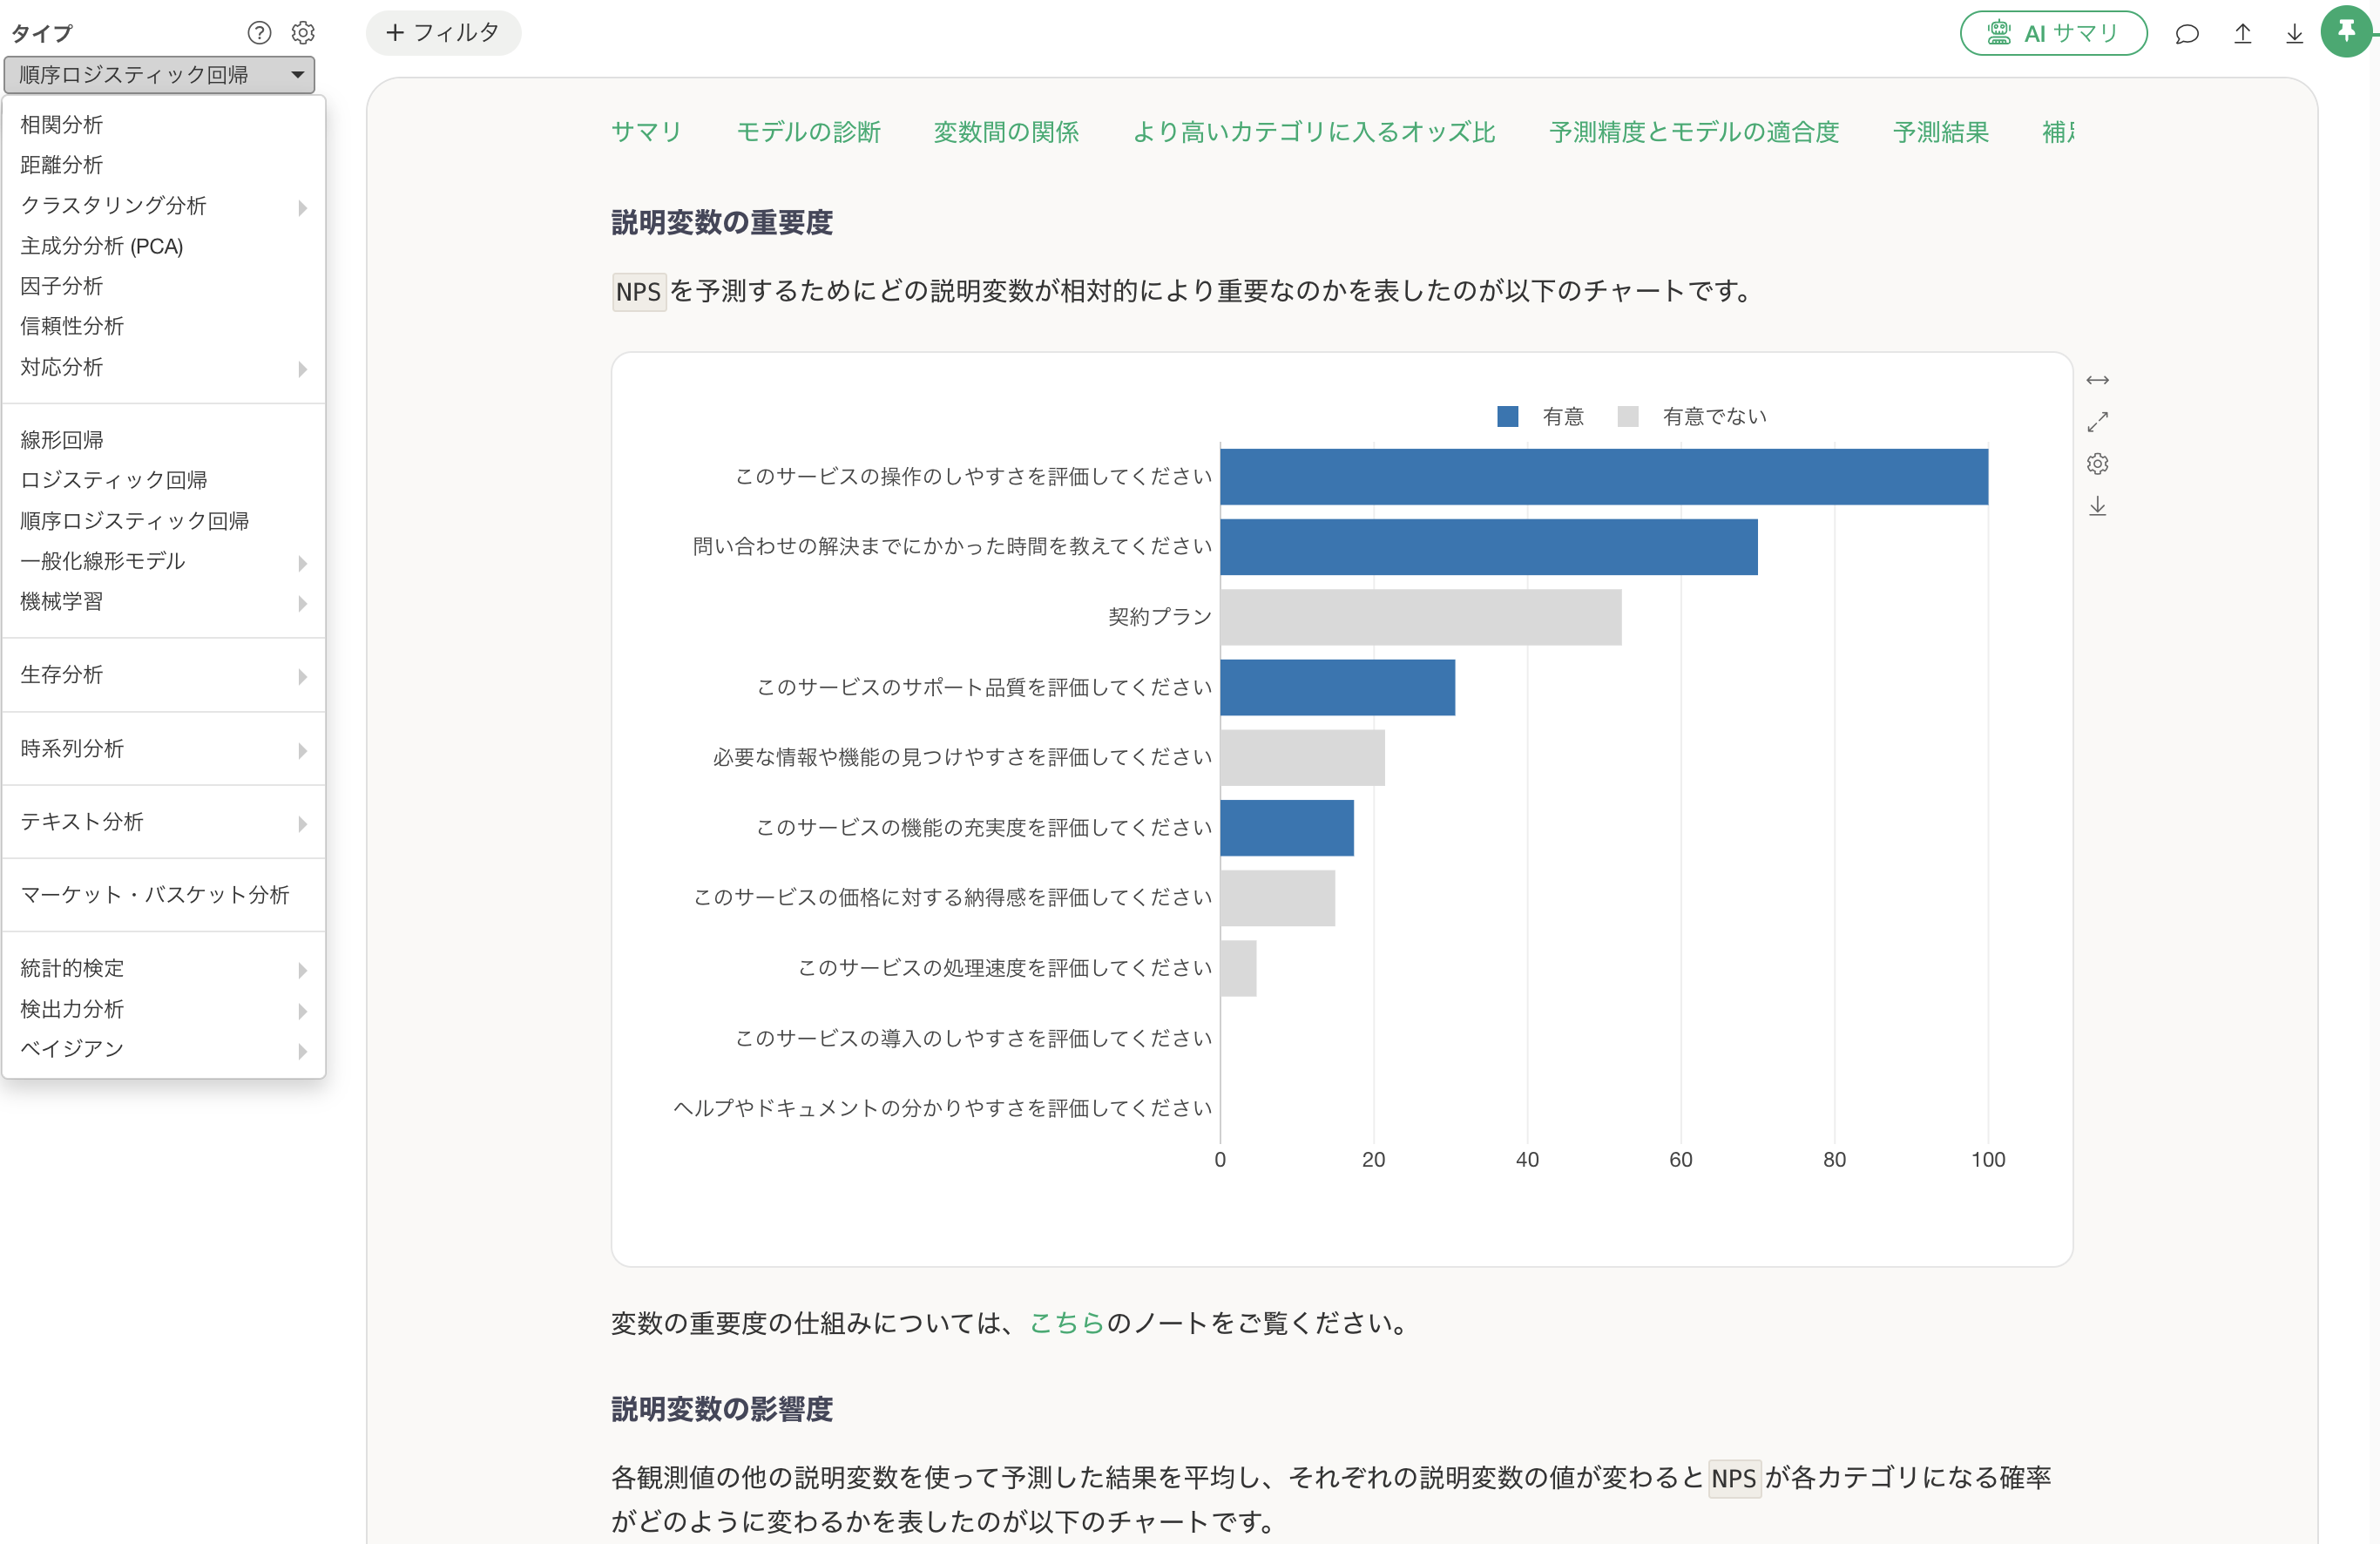
Exploratoryでは、例えば以下のような分析をグラフィカルなインターフェースから利用できます。
- 仮説検定
- 相関分析
- 線形回帰
- ロジスティック回帰
- 順序ロジスティック回帰
- 主成分分析
- 因子分析
- 信頼性分析
- クラスタリング
- 決定木
- CHAID
- 時系列分析
- 生存分析
- テキスト分析
分析結果は数値だけで表示されるのではなく、チャートや解説とともに確認できるため、統計手法そのものを専門としていないユーザーでも結果を解釈しやすくなっています。
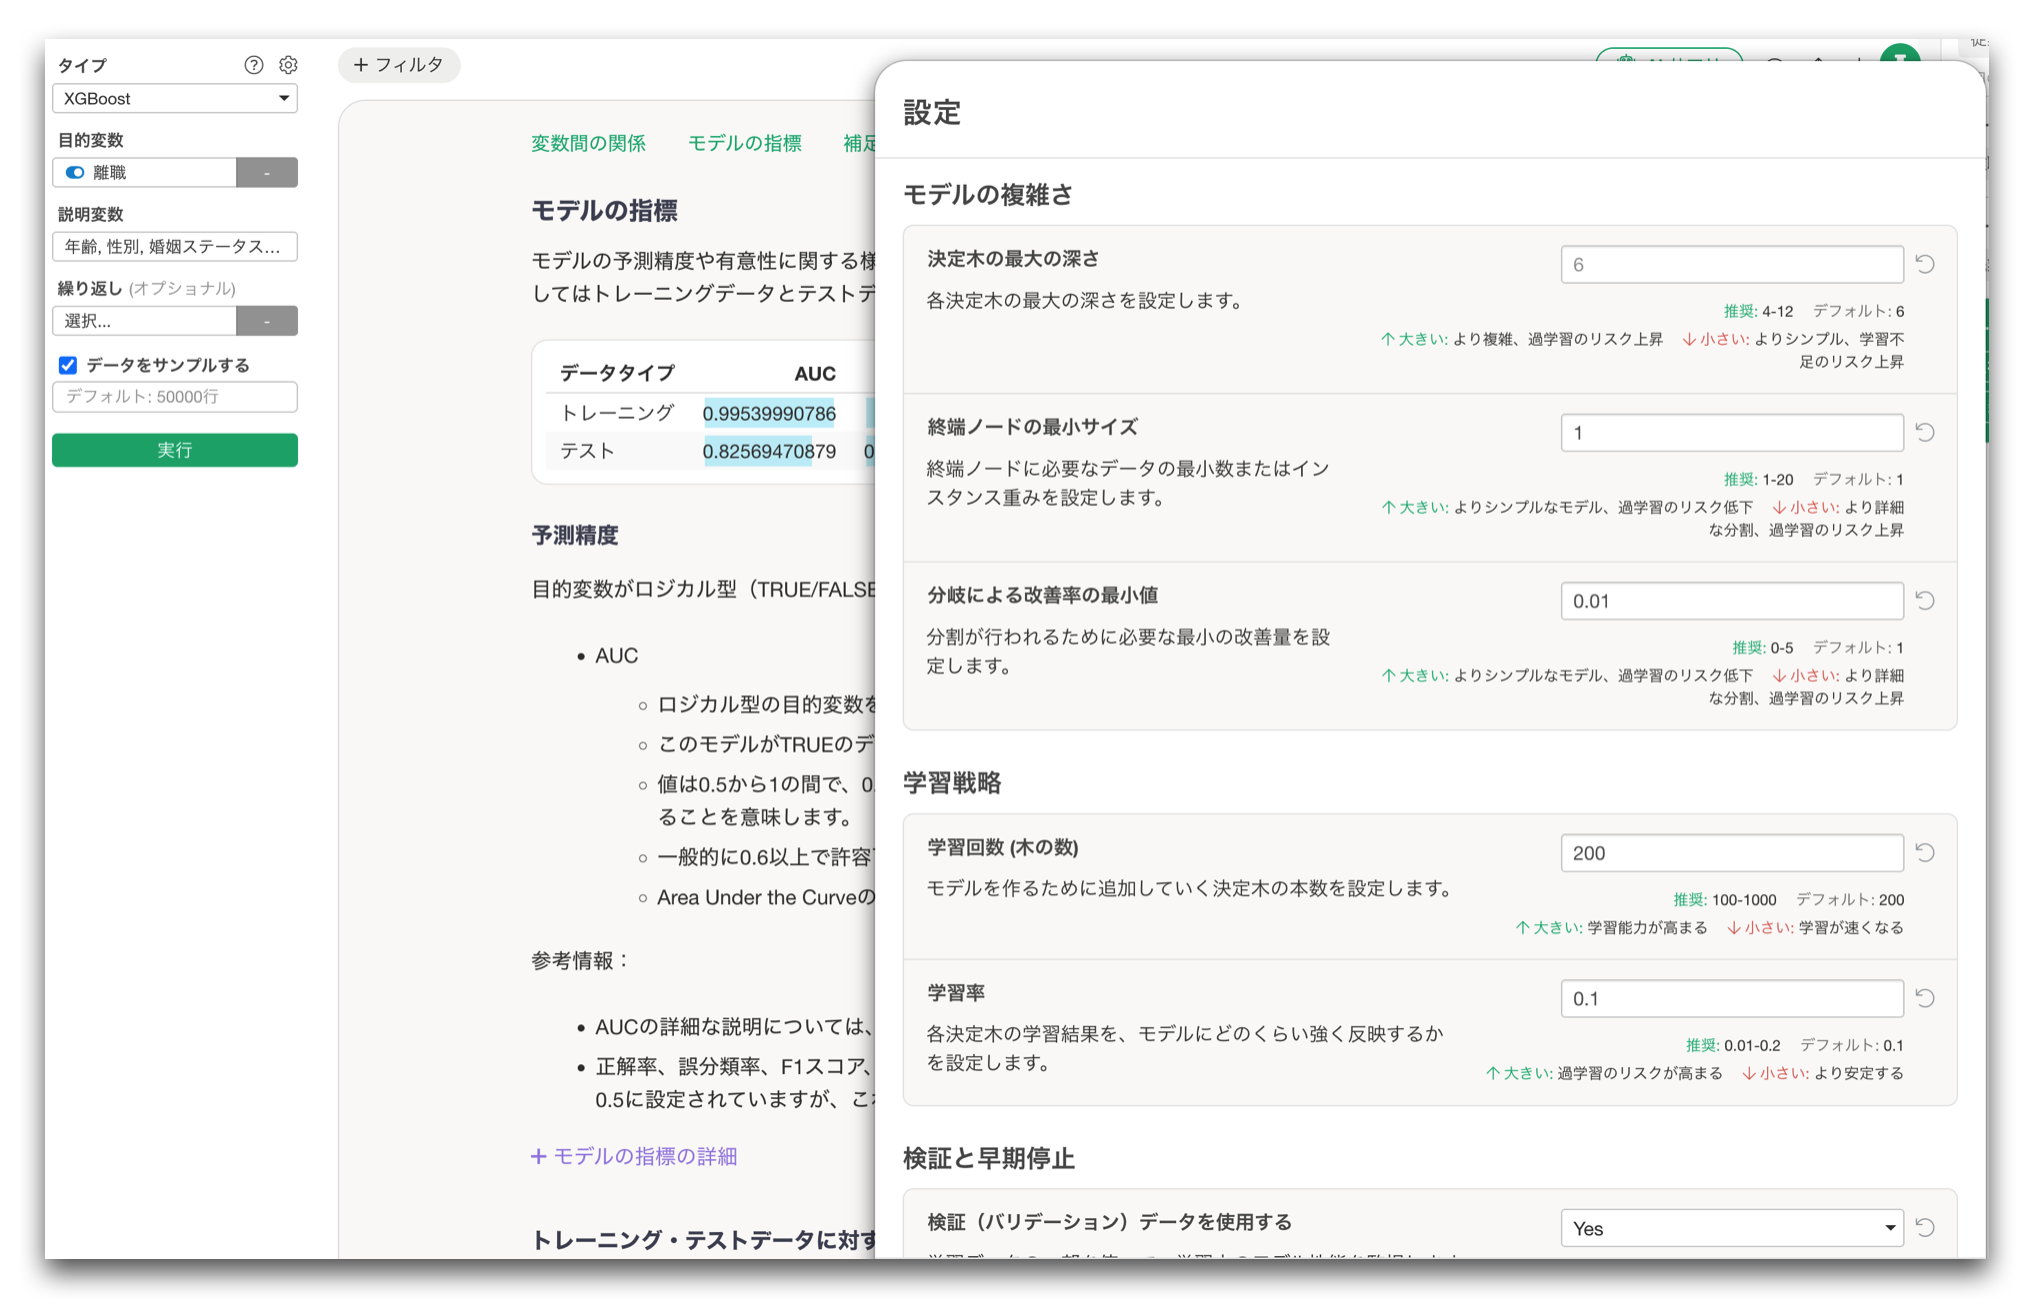
また、様々な機械学習モデルを使って予測モデルを構築し、予測精度を上げるためにパラメーターをチューニングすることもできます。
AIをデータ分析のワークフローに活用する
Exploratoryでは、AIもデータ分析ワークフローの中で活用することができます。
例えば、自然言語で欲しいデータを指示することで、AIがデータへのアクセス方法を考え、必要なRスクリプトを生成してデータを取得するといった使い方ができます。
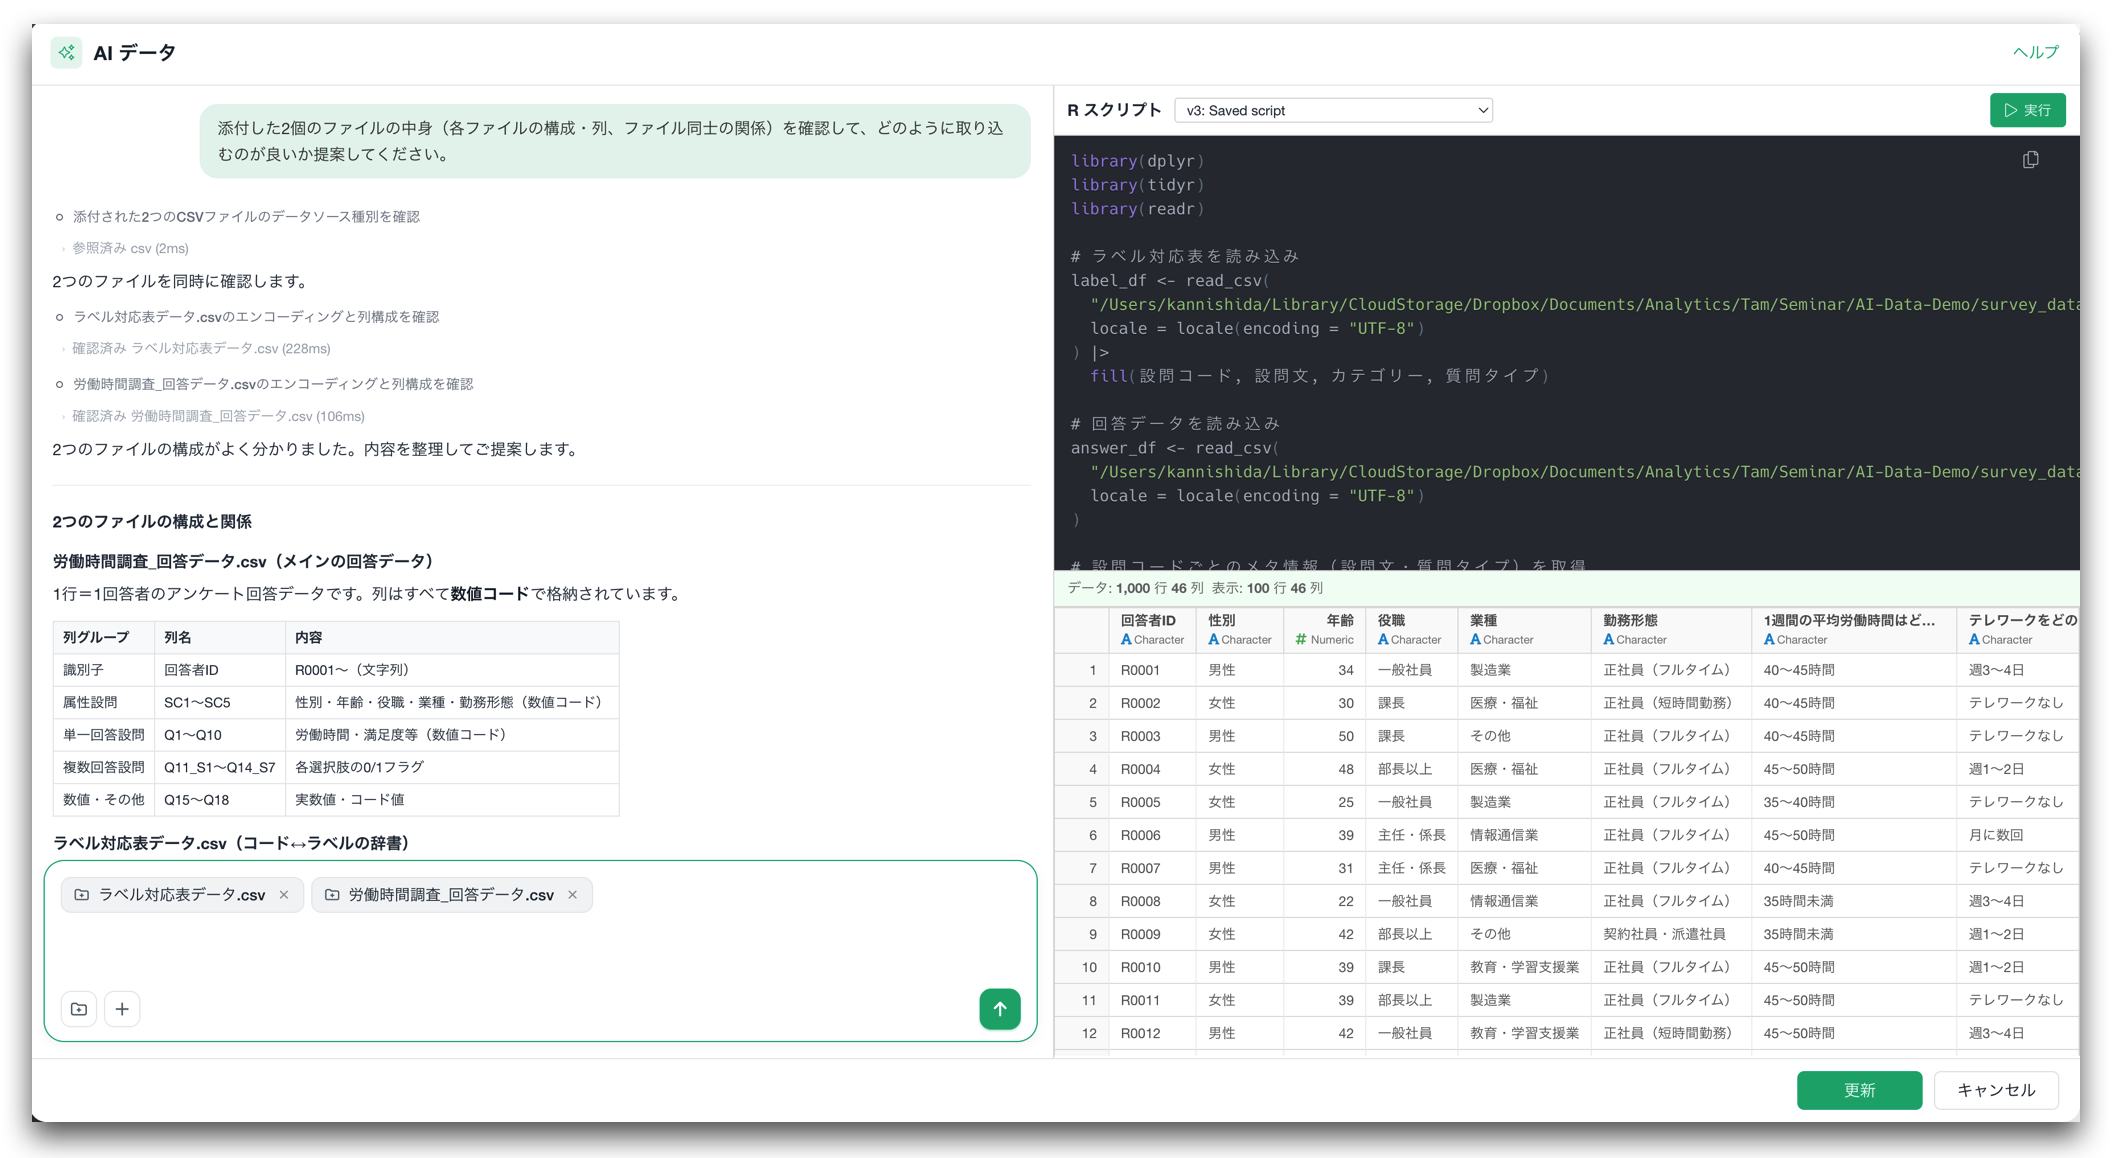
さらに、テキストデータの分類や分析など、これまで手作業では時間がかかっていた作業にもAIを利用することができます。
重要なのは、AIだけが独立して存在しているのではなく、AIを使って取得・加工したデータを、そのまま可視化や統計分析へつなげられることです。
分析結果を伝え、共有する
分析の目的は、分析することそのものではありません。
データから分かったことを他の人に伝え、意思決定や行動につなげることが重要です。
Exploratoryでは、分析結果をチャートやダッシュボードだけでなく、文章と組み合わせたノートとしてまとめることができます。
また、ビジネス指標のモニタリングやトレンドを定点観測するためにダッシュボードを作ることもできます。
さらにExploratory Serverを利用することで、作成したダッシュボード、ノートなどをWeb上で共有し、さらにスケジュールすることでデータを常に最新の状態にすることもできます。
共有された人は、チャートをクリックしたり、パラメーターを使うことで、ダッシュボードやノート内のデータをインタラクティブに深堀りすることもできます。分析担当者だけが結果を見るのではなく、必要な人が最新の分析結果にアクセスできる環境を作ることができます。
Exploratoryは誰のためのツールなのか?
Exploratoryは、データ分析を仕事にしている専門のデータサイエンティストだけを対象とした製品ではありません。
むしろ、日々の仕事の中でデータを使って意思決定を行うアナリストやビジネスユーザーが、より高度な分析を自分自身で行えるようにすることを目的としています。
データアナリスト
データアナリストの仕事では、チャートを作るだけでなく、その前に大量のデータ加工を行い、その後に統計分析やレポート作成を行うことがあります。
これらを複数のツールに分けて行うと、データをコピーしたり、同じ処理を繰り返したりする必要が生じます。
Exploratoryでは、データの取得、加工、探索、分析、共有を1つの再利用可能なワークフローとして管理できます。
そのため、繰り返し発生する分析業務を効率化することができます。
ビジネスアナリスト
ビジネス上の課題を理解するためには、単純な集計だけではなく、統計分析や機械学習が役立つことがあります。
しかし、そうした分析を行うために毎回RやPythonのプログラムを書くことは、たとえAIで簡単に生成できるとしても、その管理や更新などを考慮すると、多くのビジネスユーザーにとって現実的ではありません。
Exploratoryでは、データ加工や可視化だけでなく、回帰分析、クラスタリング、決定木などの分析もグラフィカルなインターフェースから利用できます。
そのため、プログラミングを専門としていないビジネスユーザーでも、より深いデータ分析に取り組むことができます。
研究者やアンケート分析担当者
大学や研究機関、マーケティングリサーチ、人事などでは、アンケートデータを分析する機会が多くあります。
アンケートデータには、
- 5段階評価のような順序付きカテゴリ(リッカート尺度)
- 複数回答
- 自由記述
- 多くの質問列
- 長い質問文を持つ列名
など、データを取り扱う際に、一般的なビジネスデータとは異なる特徴、課題があります。
Exploratoryでは、こうしたアンケートデータの加工や可視化だけでなく、クロス集計、因子分析、信頼性分析、クラスタリング、順序ロジスティック回帰、CHAID、などを使った分析、AIやトピックモデルを使ったテキスト分析まで行うことができます。
Rをもっと視覚的に使いたいユーザー
Rは、データ加工、統計分析、機械学習などにおいて非常に強力な環境です。
一方で、すべての処理をコードとして記述する必要があるため、分析を始めるまでのハードルを高く感じるユーザーもいます。
Exploratoryは、Rを分析エンジンとして使用しながら、その能力をグラフィカルなインターフェースから利用できるようにしています。
Rを置き換えるのではなく、Rのエコシステムをより視覚的なワークフローで利用するための選択肢と考えることができます。
Exploratoryはどのように動くのか?
Exploratoryでの典型的なデータ分析は、次のような流れで進みます。
データを取り込む → 加工する → 探索する → 分析する → 結果を伝える
これらを別々のツールで行うのではなく、同じプロジェクトの中でつなげて管理します。
視覚的なワークフロー
Exploratoryでは、データ加工や分析の処理をステップとして積み重ねていきます。
例えば、
「不要な行を除く」
「地域ごとに集計する」
「売上成長率を計算する」
といった処理が、それぞれ目に見える形で記録されます。
そのため、最終結果だけでなく、その結果がどのような処理によって作られたのかを後から確認できます。
<image>
Rを分析エンジンとして利用
Exploratoryの背後ではオープンソースのRが動いています。
データ加工ではtidyverseをはじめとするRのエコシステムを利用し、統計分析や機械学習についてもRで実績のあるさまざまな手法やパッケージを活用しています。
つまりExploratoryは、独自のクローズな分析エンジンを一から作っているわけではありません。
Rが持つ分析能力を、グラフィカルなインターフェースを通して利用できるようにしたプラットフォームです。
再現可能な分析
Excelなどを使った分析では、同じ作業を翌月や翌年にもう一度行う場合、以前と同じ操作を手作業で繰り返すことがあります。
Exploratoryでは、加工や分析の手順そのものが保存されています。
そのため、データが更新されても同じワークフローを再実行できます。
これは、毎週、毎月、毎年繰り返される分析業務では特に重要です。
単に作業時間を減らすだけでなく、毎回異なる操作をしてしまうリスクを抑え、分析の再現性を高めることができます。
Exploratoryは他のデータ分析ツールと何が違うのか?
データ分析ツールには、表計算(スプレッドシート)、BI、統計解析、プログラミング環境など、さまざまな種類があります。
Exploratoryの特徴は、そのどれか1つの機能だけに特化するのではなく、データ分析に必要な複数の工程を1つのワークフローとしてつなげていることです。
データ加工と分析が1つの場所にある
データ分析では、
データ加工にはツールA、可視化にはツールB、統計分析にはツールC、
というように複数のツールを使い分けることがあります。
Exploratoryでは、データ加工、可視化、統計分析、機械学習を同じデータとワークフローの上で行うことができます。
分析の途中で加工方法を変えたり、可視化から統計分析へ進んだりしても、データを書き出して別のツールに移動する必要がありません。
高度な分析をグラフィカルなインターフェースから使える
高度な分析を行うために、必ずしもRやPythonのコードを最初から自分で書く必要はありません。
Exploratoryでは、統計分析や機械学習の多くをグラフィカルなインターフェースから設定できます。
一方で、背後にはRがあるため、必要に応じてRの能力を利用することもできます。
つまり、
使いやすいUIと、Rの分析能力を組み合わせている
ことがExploratoryの大きな特徴です。
オープンなRエコシステムの上に構築されている
ExploratoryはRをベースにしています。
これは単に「Rで作られている」というだけではありません。
長年にわたり研究者やデータサイエンティストによって開発されてきたRの統計手法やデータ処理パッケージを活用できるということです。
そのため、新しい分析手法をExploratoryに取り込む際にも、Rエコシステムの資産を活用できます。
分析を再利用できる
分析結果だけではなく、そこに至るまでのデータ加工や分析のステップを保存できることも特徴です。
例えば毎月同じレポートを作る場合、翌月は新しいデータを取り込んで既存のステップを実行するだけで、同じ分析を更新できます。
これは、Excelで同じ作業を毎回手動で繰り返す方法とは大きく異なります。
探索から共有までをつなげられる
Exploratoryでは、データを探索し、統計分析を行い、その結果をチャートや文章としてまとめ、さらに共有するところまでつなげることができます。
「分析する人」と「結果を見る人」の間を分断せず、分析結果を意思決定につなげるためのワークフローを作ることができます。
データをローカルPCに置いたまま分析できる
Exploratory Desktopに取り込んだデータは、ユーザーが明示的にサーバーへパブリッシュしない限り、ローカルPC内に保存されます。そのため、クラウドへデータをアップロードすることを前提とせず、データ加工、可視化、統計分析、機械学習を行うことができます。
Exploratoryではデータをどのように安全に扱うのか?
Exploratory Desktopでは、インポートしたデータはローカルPC内に保存されます。
Exploratoryを使ってデータを加工、可視化、分析しているだけで、そのデータが自動的にExploratoryのクラウドへアップロードされることはありません。
ユーザーが明示的にExploratory Serverへパブリッシュしない限り、データは利用しているPC上に留まります。
そのため、機密性の高い業務データや顧客データ、研究データなどを扱う場合でも、まずローカル環境の中でデータ分析を行うことができます。
データはローカルPC上で分析できる
Exploratory Desktopにインポートしたデータは、ユーザーのローカルPC内に保存されます。
データの加工、チャート作成、統計分析、機械学習などもDesktop上で行うことができます。
クラウドベースの分析サービスのように、分析を始めるためにデータを外部サーバーへアップロードすることを前提としていません。
この点は、企業内の機密データや外部への持ち出しが制限されているデータを扱う場合に特に重要です。
必要なときだけサーバーへパブリッシュする
分析結果を他の人と共有したり、ダッシュボードをWeb上で公開したり、スケジュール更新を利用したい場合には、ユーザー自身がExploratory Serverへパブリッシュします。
つまり、Desktopで分析することとServerへデータを公開・共有することは明確に分かれています。
何をサーバーへパブリッシュするかは、ユーザー自身がコントロールできます。
サーバー上でもプライベートに共有できる
Exploratory Serverへパブリッシュした場合でも、必ず一般公開されるわけではありません。
特定のメンバーだけを招待し、分析結果やデータをプライベートに共有することができます。
また、サーバー上に保存されたデータは暗号化して保存されます。
そのため、ローカルPCで分析する
→ 必要になったものだけをサーバーへパブリッシュする
→ 必要なメンバーだけとプライベートに共有する
という形で、データの扱いをユーザー自身がコントロールできます。
Exploratoryではどのようなデータを分析できるのか?
Exploratoryは特定の業界や1種類のデータだけを対象としているわけではありません。
さまざまな種類のデータを扱うことができます。
ビジネスや業務データ
例えば、
- 売上
- マーケティング
- 顧客
- 製品
- Webアクセス
- 業務実績
- 財務
などのデータを分析できます。
時系列でトレンドを見るだけでなく、顧客や商品をグループに分けたり、結果に影響する要因を分析したりすることもできます。
アンケート・質問票データ
Exploratoryが特に力を入れている領域の1つがアンケートデータ分析です。
アンケートでは、単純な数値データだけでなく、
- 5段階評価などの順序付きカテゴリ
- 複数回答
- Top 2 Box / Bottom 2 Box
- 自由記述
- 多数の質問列
などを扱う必要があります。
Exploratoryでは、こうしたデータを加工し、クロス集計や可視化を行うだけでなく、因子分析、信頼性分析、クラスタリング、CHAID、順序ロジスティック回帰などを使って、回答の背景にある構造や要因まで分析することができます。
時系列データ
売上、アクセス数、利用者数など、時間とともに変化するデータを分析できます。
単純なトレンドだけでなく、季節性、変化点、予測などの分析にも利用できます。
テキストデータ
アンケートの自由記述、顧客コメント、問い合わせ内容などのテキストデータも分析できます。
単語の出現傾向を見るだけでなく、AIを利用して内容を分類したり、感情やテーマを分析したりすることもできます。
Exploratoryの代表的な利用例
Exploratoryは業界ごとに異なるデータ分析の課題に利用されています。
アンケートデータ分析
アンケートでは、
「どの回答が多かったか」
を見るだけではなく、
「どのグループで回答傾向が違うのか」
「満足度に影響している要因は何か」
「回答者をどのようなタイプに分けられるか」
といった問いに答える必要があります。
Exploratoryでは、クロス集計、統計的検定、因子分析、クラスタリング、CHAID、回帰分析などを使い、集計からより深い分析へ進むことができます。
顧客・マーケティング分析
顧客データを使って、
- 顧客セグメントを理解する
- 購入や解約に影響する要因を特定する
- マーケティング施策の効果を比較する
- ブランドや顧客意識を分析する
といった用途に利用できます。
HR・人事データ分析
人事領域では、
- 従業員エンゲージメント
- 離職
- 人材育成
- 組織ごとの違い
- マネジャーや職場環境の影響
といった課題を分析できます。
例えばエンゲージメントサーベイの結果について、単純に平均スコアを比較するだけでなく、どの要因がエンゲージメントに強く関係しているのかを統計的に分析することができます。
大学IR・教育データ分析
大学のIRでは、学生、入試、授業、成績、アンケートなど、複数のシステムから取得したデータを継続的に分析する必要があります。
毎年同じデータ加工や集計を繰り返す業務も多いため、Exploratoryの再利用可能なデータ加工ステップが役立ちます。
業績・KPI分析
企業のKPIや業績データを定期的に分析し、ダッシュボードとして共有することもできます。
データが更新されるたびに一からレポートを作るのではなく、既存のワークフローを使って最新の結果を更新できます。
統計モデリングや研究
回帰分析、因子分析、クラスタリングなど、より高度な統計分析を必要とする研究や分析にも利用できます。
特に、Rの分析能力を利用したい一方で、毎回すべてをコードとして書きたくない場合に適しています。
Exploratoryは他の分析ツールとどう違うのか?
Exploratoryは、Excel、Tableau、Power BI、SPSS、Rなどと一部の機能が重なります。
ただし、それぞれ得意とする領域は異なります。
ExploratoryとExcelの違い
Excelは、表計算、簡単な集計、手作業でのデータ確認などに非常に便利なツールです。
一方、データ量が増えたり、複雑な加工を毎回繰り返したり、高度な統計分析を行ったりする場合には、作業の管理が難しくなることがあります。
Exploratoryでは、加工手順をステップとして保存し、その後の可視化や分析まで同じワークフローで管理できます。
そのため、繰り返し発生する分析や、複数の処理を組み合わせる分析に向いています。
ExploratoryとTableau、Power BIの違い
TableauやPower BIは、ビジネスデータを可視化し、ダッシュボードとして共有するBI領域に強みがあります。
Exploratoryもチャートやダッシュボードを作ることができますが、より大きな特徴は、可視化の前後にあるデータ加工と統計分析を重視していることです。
例えば、
「売上が下がっている」
ことを可視化するだけでなく、
「どの要因が売上に関係しているのか」
「顧客をどのようなグループに分けられるのか」
まで分析したい場合に、Exploratoryの統計分析や機械学習を利用できます。
ExploratoryとSPSSの違い
SPSSもExploratoryも、統計分析をグラフィカルなインターフェースから行うことができます。
一方、Exploratoryでは統計分析だけでなく、その前段階にあるデータ加工、探索、可視化、その後の共有までを同じワークフローとして管理できます。
また、分析エンジンとしてRを利用していることも大きな違いです。
どちらが適しているかは用途によって異なりますが、統計分析だけでなくデータ加工や探索を頻繁に行う場合には、Exploratoryの統合されたワークフローが役立ちます。
ExploratoryとR / RStudioの違い
Rは非常に柔軟で強力な統計プログラミング環境であり、RStudioはRを使った開発や分析を行うための代表的な環境です。
Exploratoryも同じRエコシステムを利用しています。
大きな違いはインターフェースです。
RStudioでは基本的にコードを書いて分析しますが、Exploratoryでは多くの分析をグラフィカルなインターフェースから構築できます。
そのため、
Rの能力は使いたいが、日常的な分析をすべてコードとして記述したくない
というユーザーにとって、Exploratoryは1つの選択肢になります。
Exploratoryを使うためにRを知っている必要はあるのか?
いいえ。Exploratoryで一般的なデータ加工、可視化、統計分析、機械学習を行うために、Rを知っている必要はありません。
多くの操作はグラフィカルなインターフェースから行うことができます。
例えば、データのフィルタリング、集計、結合、チャート作成、回帰分析、クラスタリングなども、基本的にはUI上で設定できます。
一方で、Exploratoryの背後ではRが動いています。
そのため、より高度なカスタマイズが必要な場合には、RのスクリプトやRパッケージを利用することもできます。
つまり、Rを知らなくても使い始めることができ、必要になったときにはRのエコシステムまで利用できるという構造になっています。
ExploratoryはBIツールなのか、統計ツールなのか、それともデータサイエンス・プラットフォームなのか?
Exploratoryには、BIツール、統計解析ソフト、データサイエンスツール、それぞれと重なる機能があります。
しかし、最も近い分類はデータサイエンス・プラットフォームです。
なぜなら、Exploratoryは単にデータを可視化するだけでも、統計分析だけを行う製品でもないからです。
Exploratoryでは、
データの取得
↓
データ加工
↓
探索・可視化
↓
統計分析・機械学習
↓
分析結果の共有
までを1つのワークフローとして扱います。
特に、専門のデータサイエンティストだけではなく、アナリストやビジネスユーザーがデータサイエンスの手法を日常の仕事に利用できるようにすることを重視しています。
その意味で、Exploratoryは、
アナリストとビジネスユーザーのための、Rをベースとしたデータサイエンス・プラットフォーム
と表現するのが最も適しています。
Exploratoryを使った典型的な分析ワークフロー
例えば、従業員エンゲージメント・サーベイを分析するとします。
1. データを取り込む
ExcelやCSVで保存されたアンケート回答データをExploratoryに取り込みます。
2. データを加工する
不要な列を除き、質問のカテゴリ順を設定し、複数回答や欠損値を分析しやすい形に整えます。
必要であれば、人事マスタなど別のデータと結合します。
3. データを探索する
質問ごとの回答分布を確認し、部署、年代、勤続年数などの属性ごとに回答傾向を比較します。
4. より深く分析する
統計的検定を使ってグループ間の違いを確認したり、回帰分析によってエンゲージメントに影響する要因を調べたりします。
さらにクラスタリングを使って、回答傾向の似ている従業員グループを見つけることもできます。
5. 結果を共有する
重要なチャートや分析結果をダッシュボードやNoteにまとめ、関係者と共有します。
翌年、新しいサーベイデータが届いた場合も、すでに作成したデータ加工や分析ステップを再利用できます。
このように、Exploratoryでは分析を単発の作業ではなく、繰り返し利用できる分析プロセスとして構築できます。
Exploratoryについてよくある質問
Exploratoryは何に使うものですか?
Exploratoryは、データの取得、加工、可視化、統計分析、機械学習、AI活用、そして分析結果の共有までを行うためのデータサイエンス・プラットフォームです。
特に、データ加工と統計分析を頻繁に行うアナリストやビジネスユーザーに適しています。
Exploratoryは誰が使っていますか?
データアナリスト、ビジネスアナリスト、研究者、マーケティングリサーチ担当者、人事担当者、大学IR担当者など、日常の業務や研究でデータ分析を行うさまざまなユーザーが利用できます。
機密データを扱っています。Exploratoryでデータを安全に分析できますか?
はい。Exploratory Desktopにインポートしたデータは、ユーザーが明示的にExploratory Serverへパブリッシュしない限り、利用しているローカルPC内に保存されます。
そのため、データをクラウドへアップロードすることを前提とせず、データ加工、可視化、統計分析などを行うことができます。
分析結果を共有したりスケジュール更新を利用するためにExploratory Serverへパブリッシュする場合でも、特定のメンバーだけを招待してプライベートに共有することができます。また、サーバー上に保存されたデータは暗号化されます。
Exploratoryはノーコードのツールですか?
Exploratoryでは、多くのデータ加工、可視化、統計分析、機械学習をグラフィカルなインターフェースから実行できるため、一般的な分析でコードを書く必要はありません。
一方でRを分析エンジンとして利用しているため、必要に応じてRコードやRパッケージを利用することもできます。
その意味では、完全にコードを排除する製品というより、コードを書かずに多くの分析ができ、必要な場合にはRまで利用できる環境と考える方が適切です。
ExploratoryはRを使っていますか?
はい。
ExploratoryはRを分析エンジンとして利用しています。
データ加工、統計分析、機械学習などでRのエコシステムを活用しながら、それらをグラフィカルなインターフェースから操作できるようにしています。
Exploratoryでアンケートデータを分析できますか?
はい。
クロス集計、複数回答、5段階評価などの順序付きカテゴリ、因子分析、信頼性分析、クラスタリング、CHAID、順序ロジスティック回帰など、アンケートデータでよく使われるさまざまな分析を行うことができます。
Exploratoryで統計分析はできますか?
はい。
仮説検定、相関分析、回帰分析、ロジスティック回帰、因子分析、主成分分析、クラスタリング、生存時間分析、時系列分析など、さまざまな統計分析をサポートしています。
Exploratoryは機械学習にも使えますか?
はい。
回帰、分類、クラスタリング、決定木など、予測やセグメンテーションに利用できる機械学習手法を利用できます。
ExploratoryとExcelは何が違いますか?
Excelは表計算や手軽なデータ確認に適しています。
Exploratoryは、複雑なデータ加工をステップとして保存し、その後の可視化、統計分析、機械学習までを再利用可能なワークフローとして管理することに重点を置いています。
ExploratoryとSPSSは何が違いますか?
両方とも統計分析をGUIから行うことができます。
Exploratoryは、統計分析だけでなく、データ加工、探索、可視化、共有までを1つのワークフローで扱う点と、Rを分析エンジンとして利用している点が特徴です。
Exploratoryはチームや組織でも使えますか?
はい。
Exploratory Desktopで作成した分析結果をExploratory ServerにPublishすることで、チャート、ダッシュボード、Noteなどをチームや組織内で共有することができます。
Exploratoryを始める
データ分析では、ツールを使うことそのものが目的ではありません。
重要なのは、データを理解し、そこから新しい問いを見つけ、意思決定につながる発見を得ることです。
Exploratoryは、データの準備から分析、共有までに必要な作業を1つのワークフローにまとめることで、より多くのアナリストやビジネスユーザーが、自分自身でデータを深く探索できるようにするためのデータサイエンス・プラットフォームです。
まずは自分のデータを取り込み、加工し、可視化するところから始めることができます。
そこから必要に応じて、統計分析、機械学習、AIへと分析を深めていくことができます。