なぜ深層学習は表形式データにおいてツリーモデルを置き換えなかったのか
なぜ XGBoost や LightGBM といったモデルが、依然として構造化データの分野を支配しているのか。
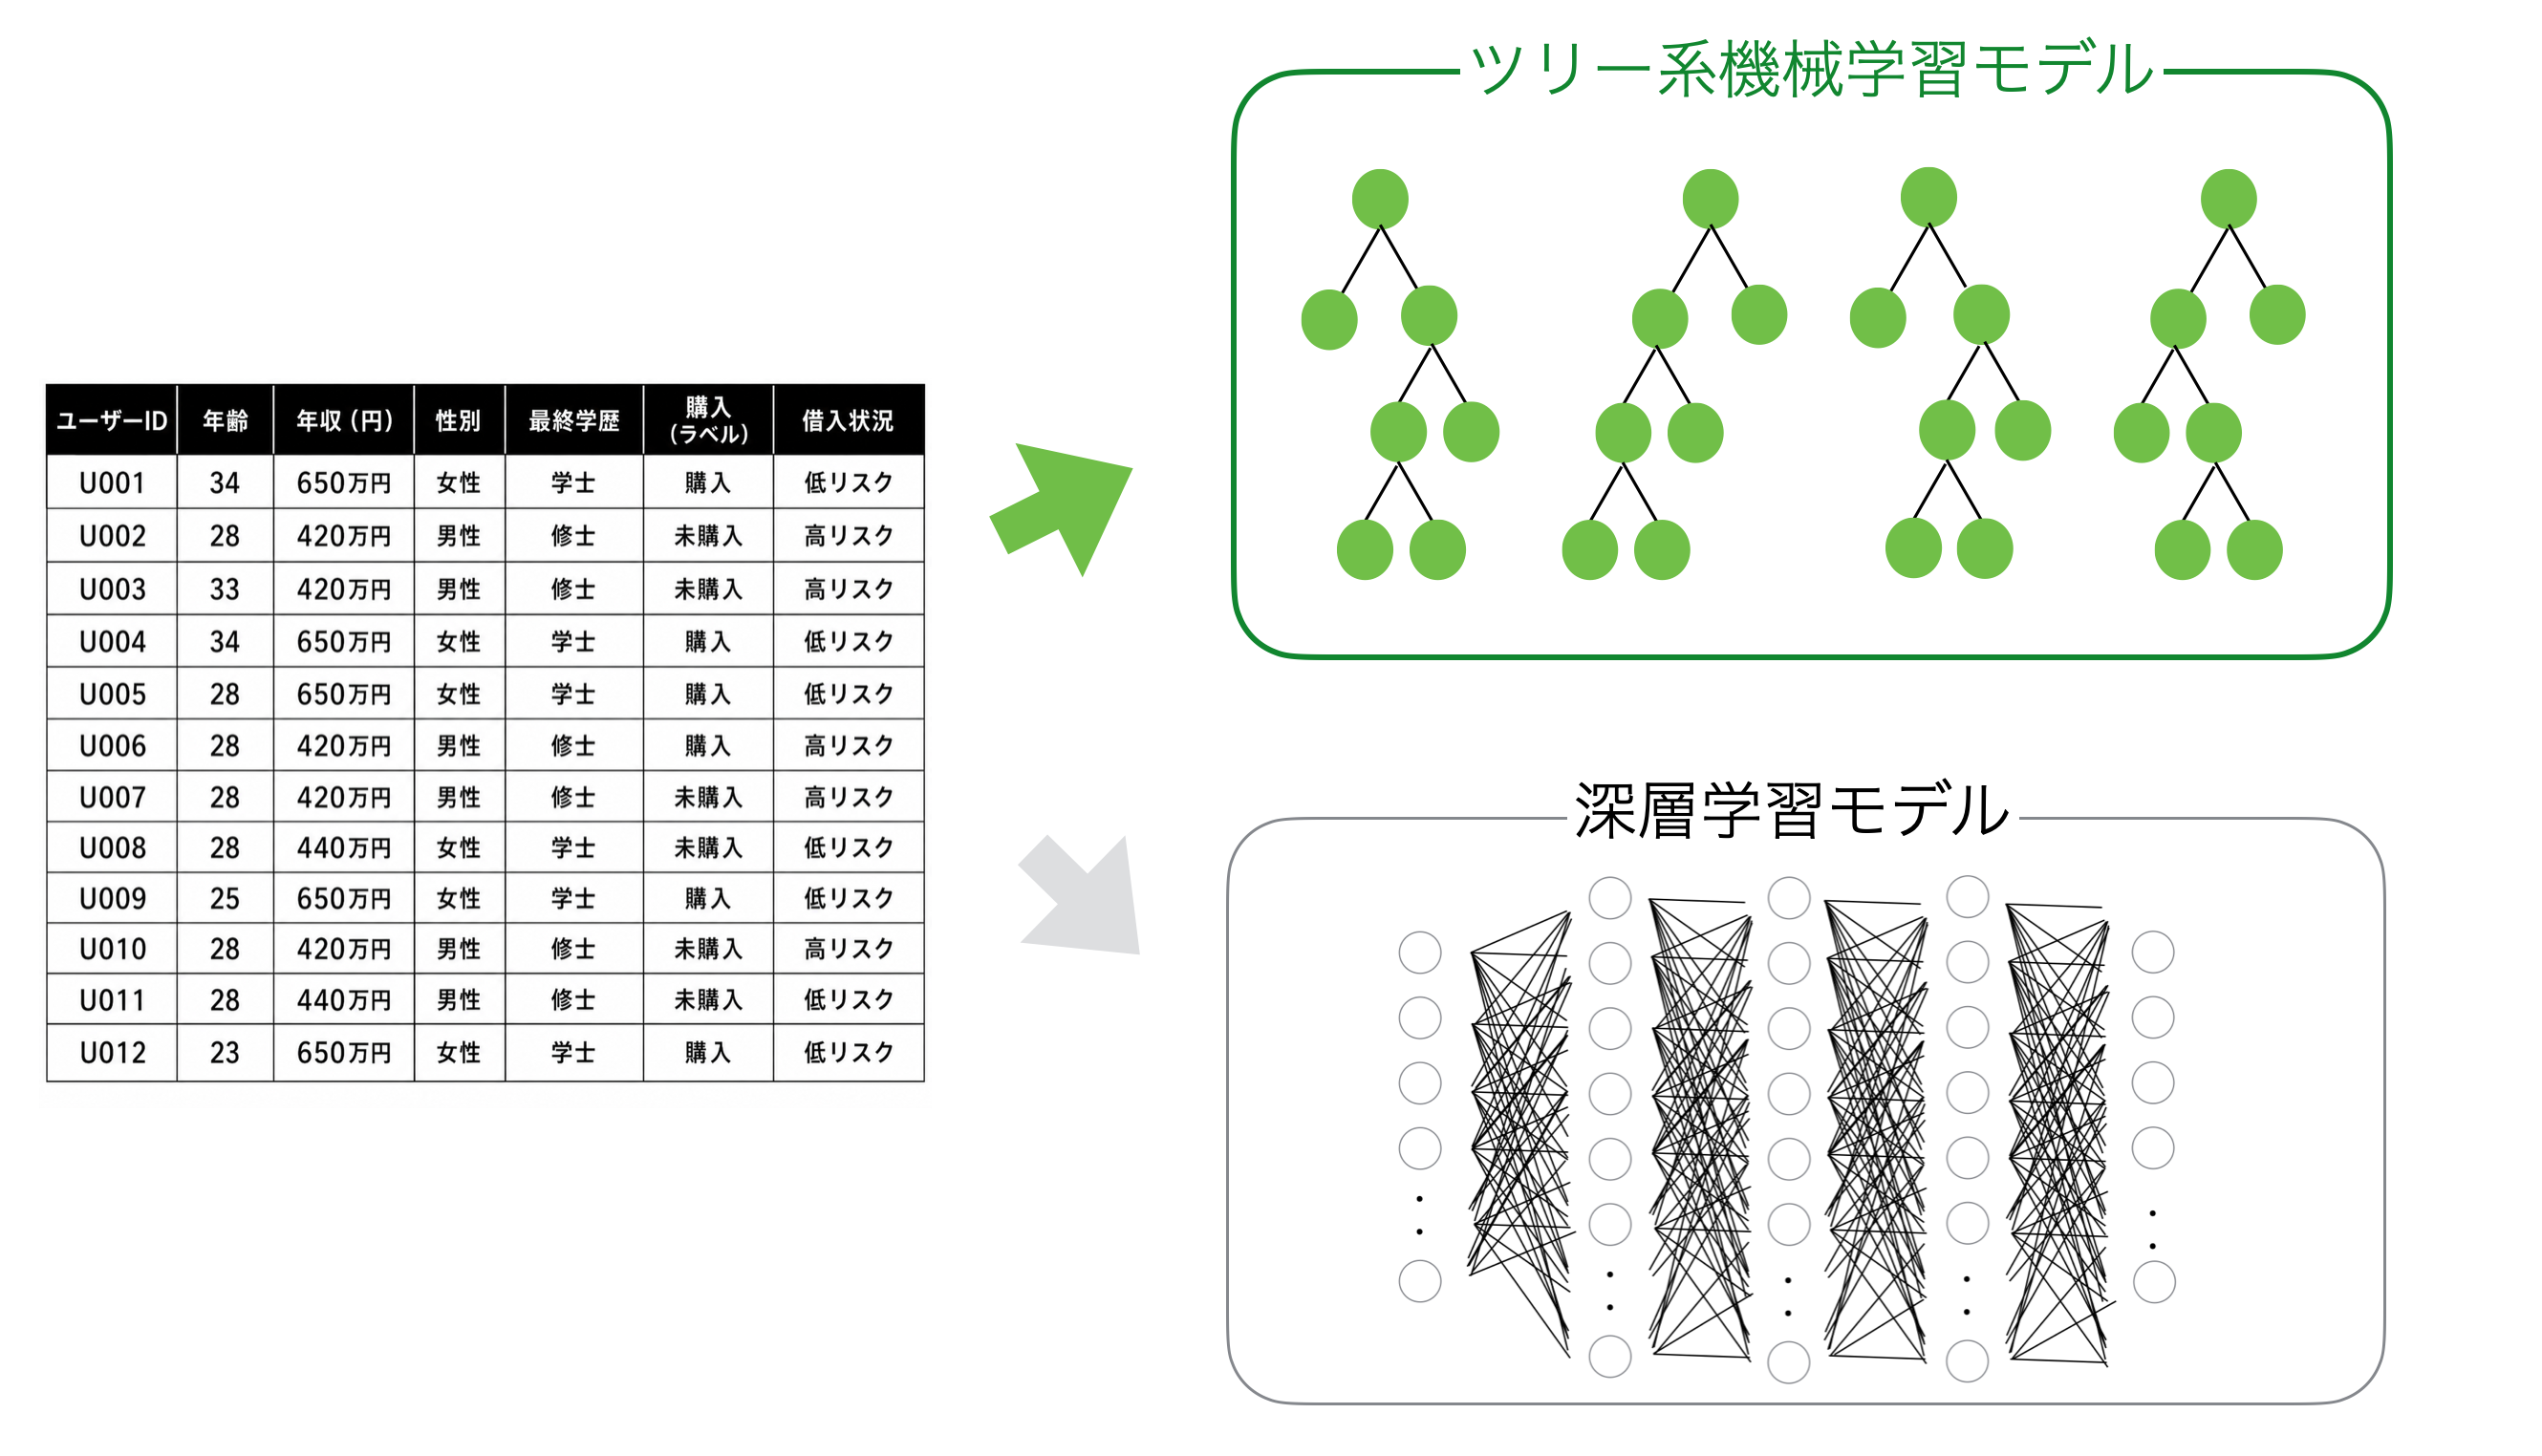
過去10年ほどの間、機械学習とAIの世界を独占してきたのは「深層学習(ディープラーニング)」でした。
深層学習のコアとなるアルゴリズムであるニューラルネットワークは、自然言語処理、画像認識、音声認識の分野に革命をもたらし、そこで使われるトランスフォーマーや畳み込みニューラルネットワーク(CNN)といったモデルは、現在、ChatGPTから自動運転に至るまで、あらゆるもののエンジンとなっています。
こうした成功を考えれば、ビジネスで使われるデータに対する予測モデルにおいても、こうした深層学習系のモデルが機械学習系(ツリー系)を置き換えるのは避けられないことだと誰もが思っていました。
ところが、現実はそうなりませんでした。
多くのビジネスで一般的に使われている「表形式データ」の世界では、深層学習がこれまでのXGBoostやLightGBMといった機械学習の予測モデルを置き換えることはありませんでした。
このことを不思議に思う人も多いかもしれません。しかし、表形式データの性質と、深層学習が得意なこと(そして不得意なこと)を理解すれば、納得できることだと思います。
ほとんどのビジネスデータは表形式データ
ほとんどのビジネスでは、数十億の画像やインターネット規模のテキストデータでAIモデルを自分たちでトレーニングする必要は一般的にありません。
代わりに、ビジネスでは次のような比較的単純なデータを使います。
| 年齢 | 収入 | 国 | 訪問回数 | 購入済み |
|---|---|---|---|---|
| 35 | 90k | US | 5 | Yes |
| 22 | 45k | UK | 1 | No |
各列はそれぞれ異なる概念を表しています。
- 属性情報(年齢、収入)
- 行動情報(訪問回数、購入)
- 地理的情報(国)
そして、画像や言語とは異なり、これらの変数(列)をつなぐ固有の構造は存在しません。
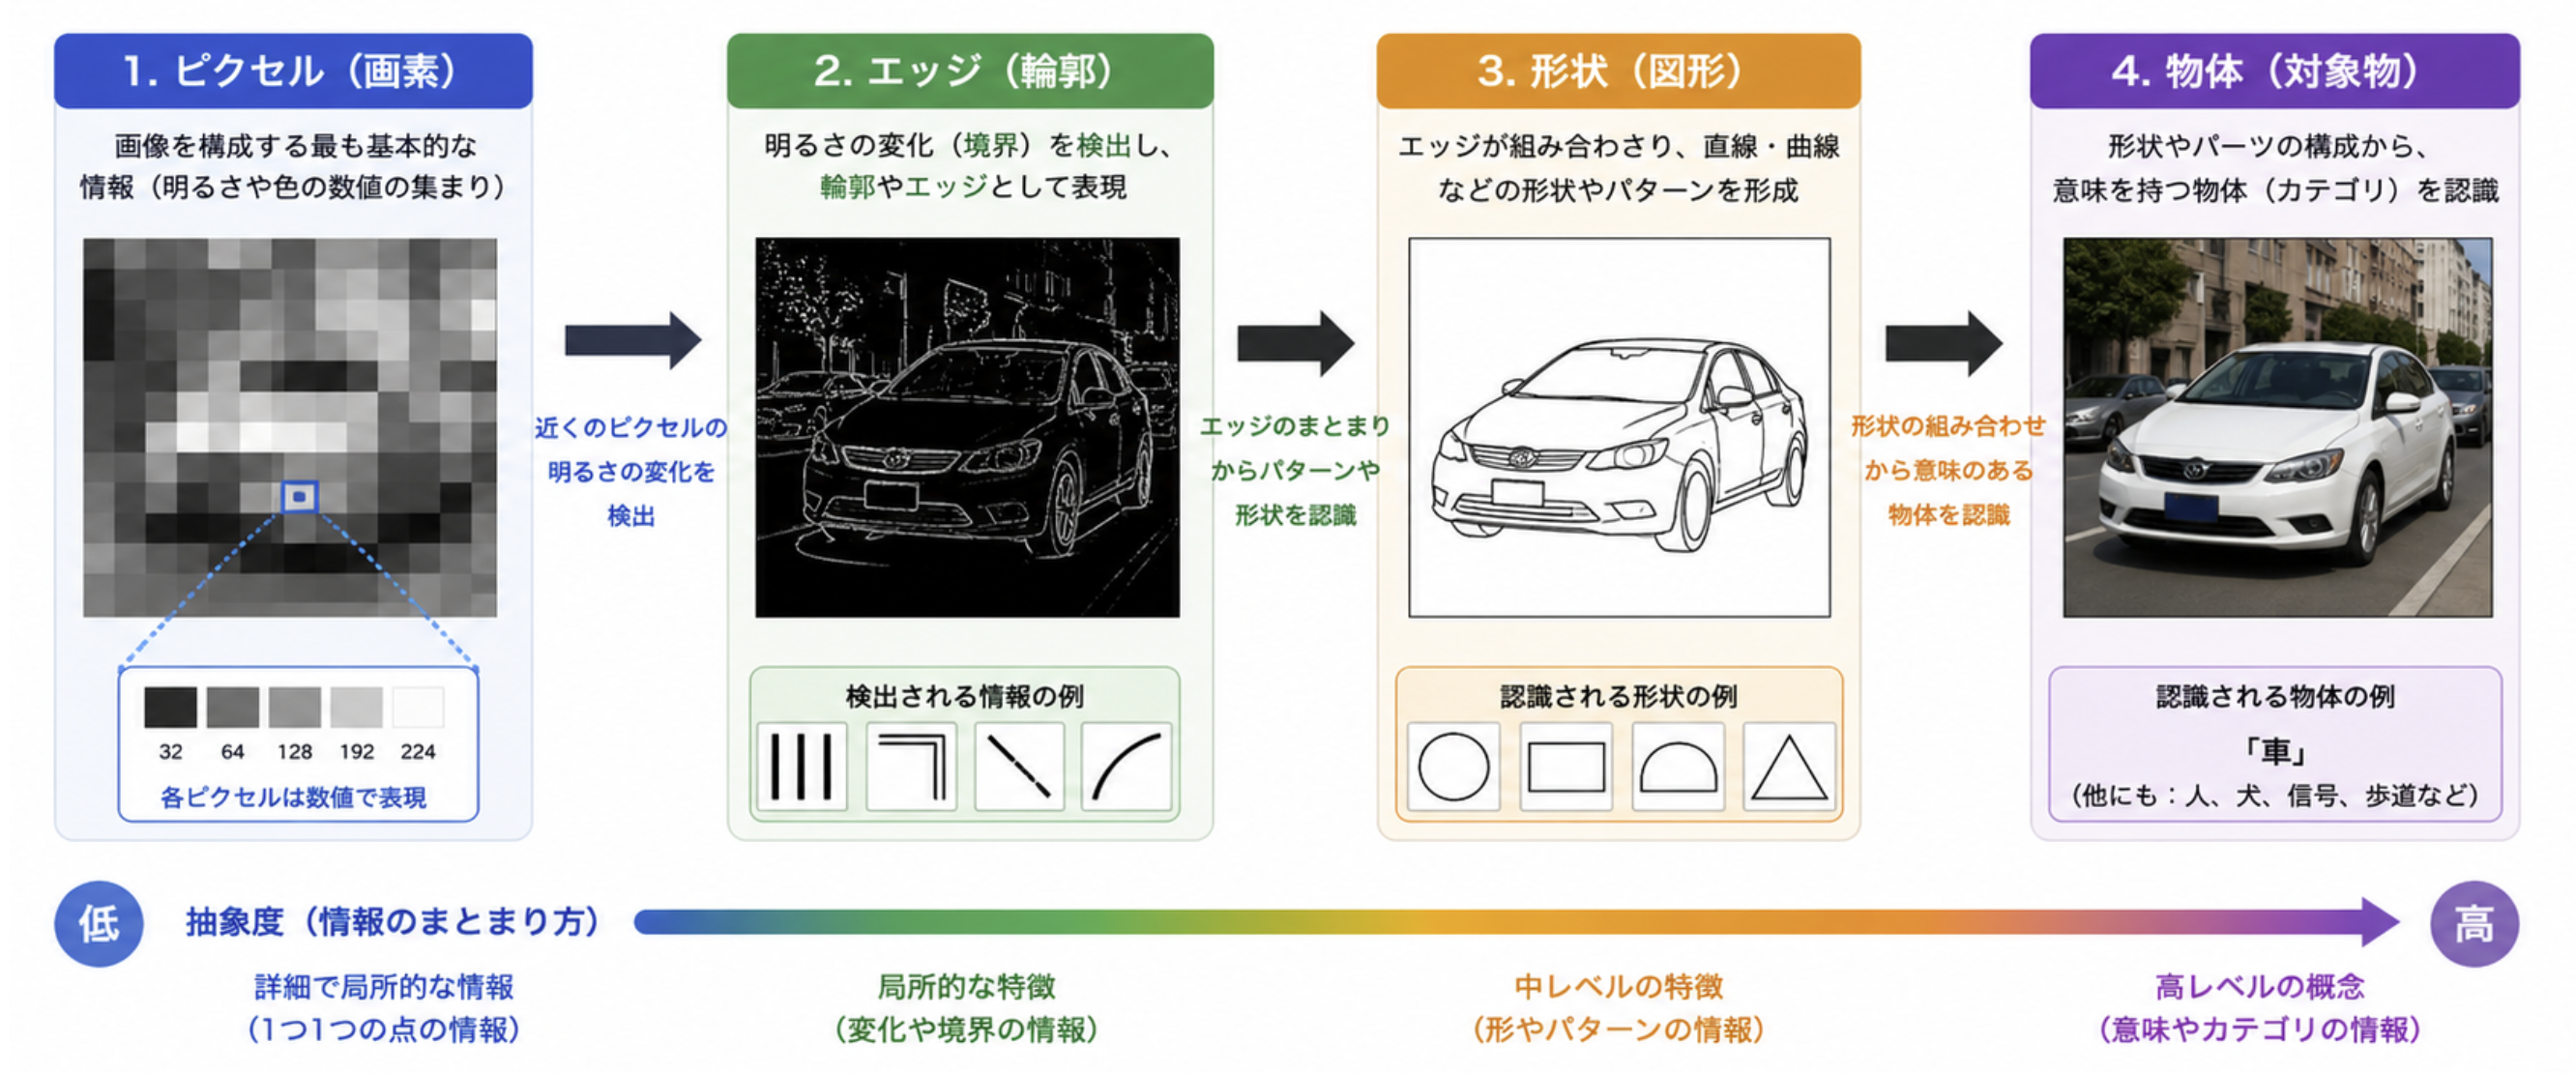
例えば、画像であれば以下のような空間的な構造があります。
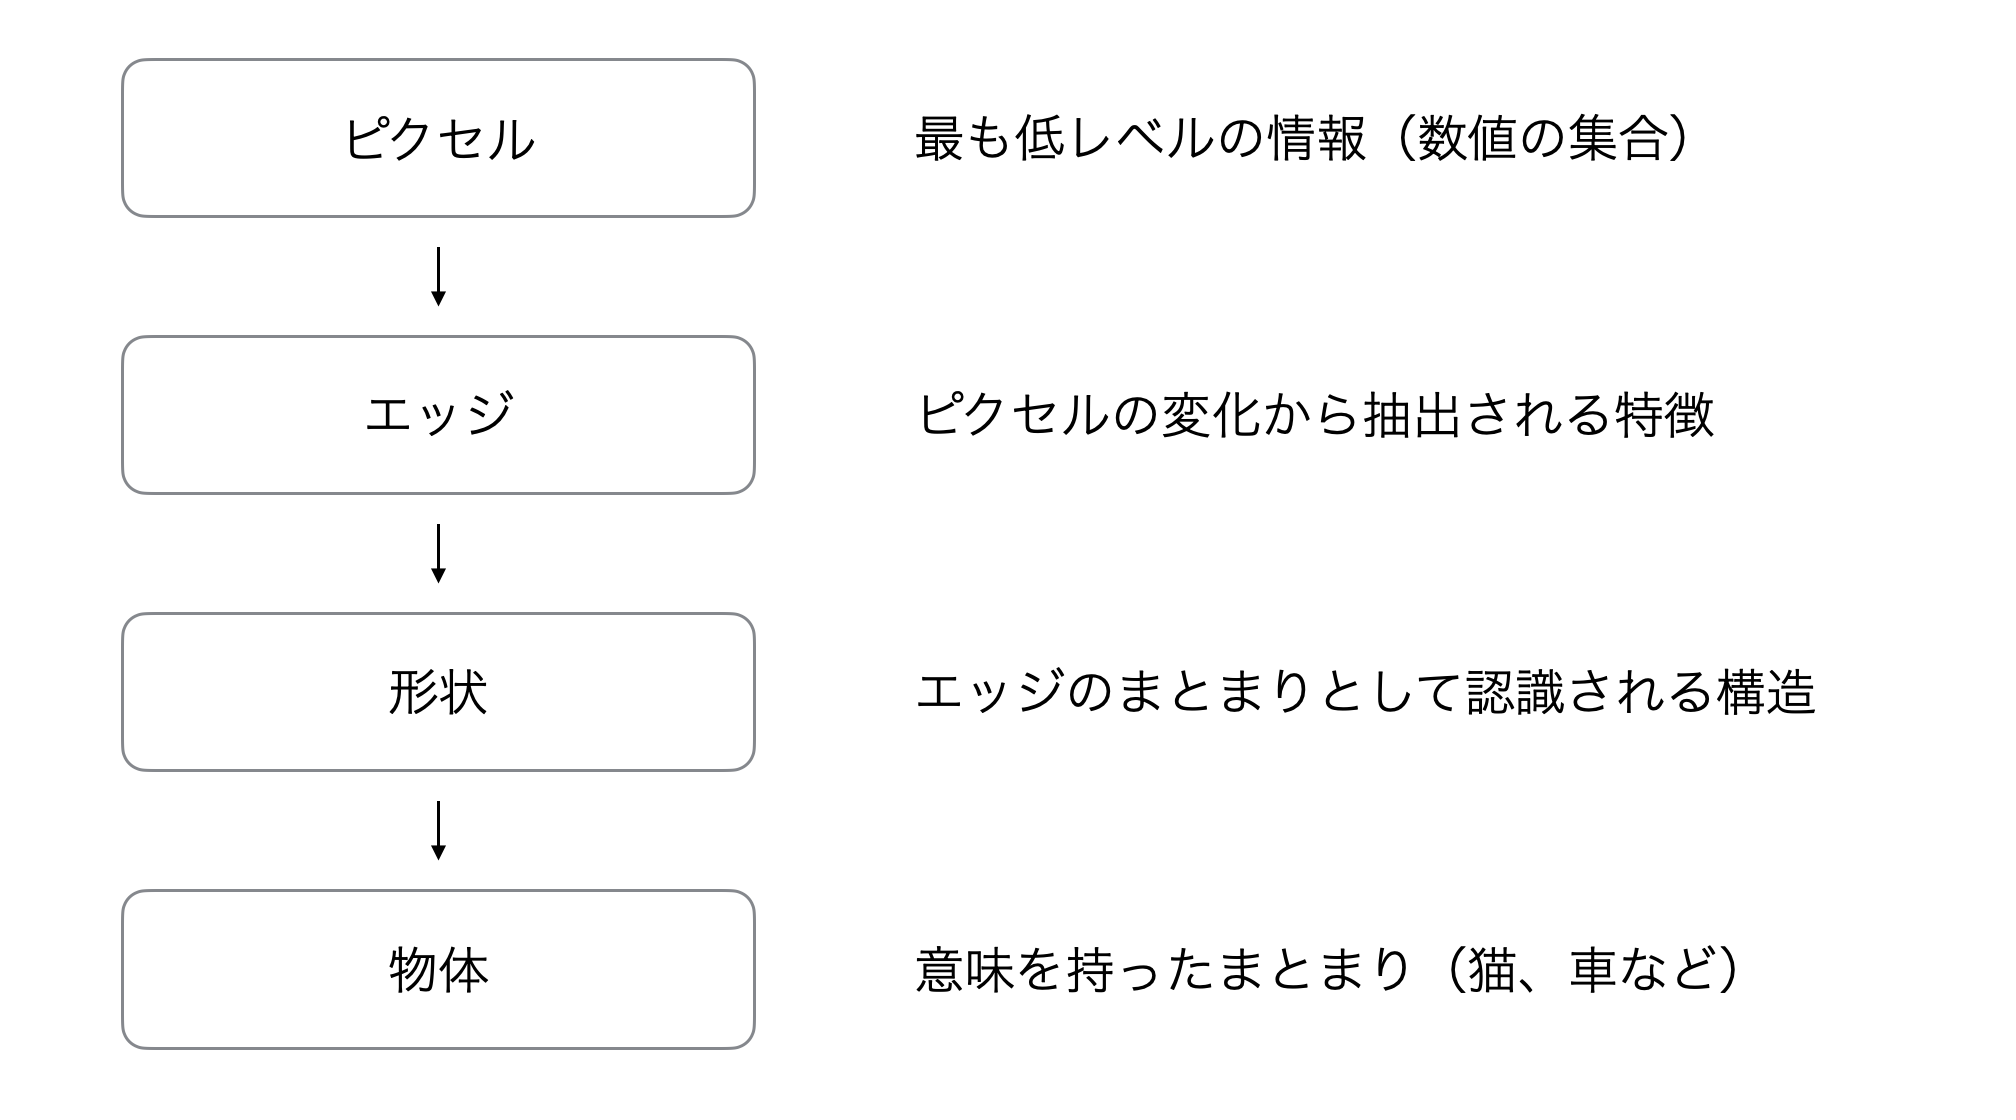
もう少し具体的に言うと、こんなかんじです。
そして、言語であれば以下のような連続的な構造があります。
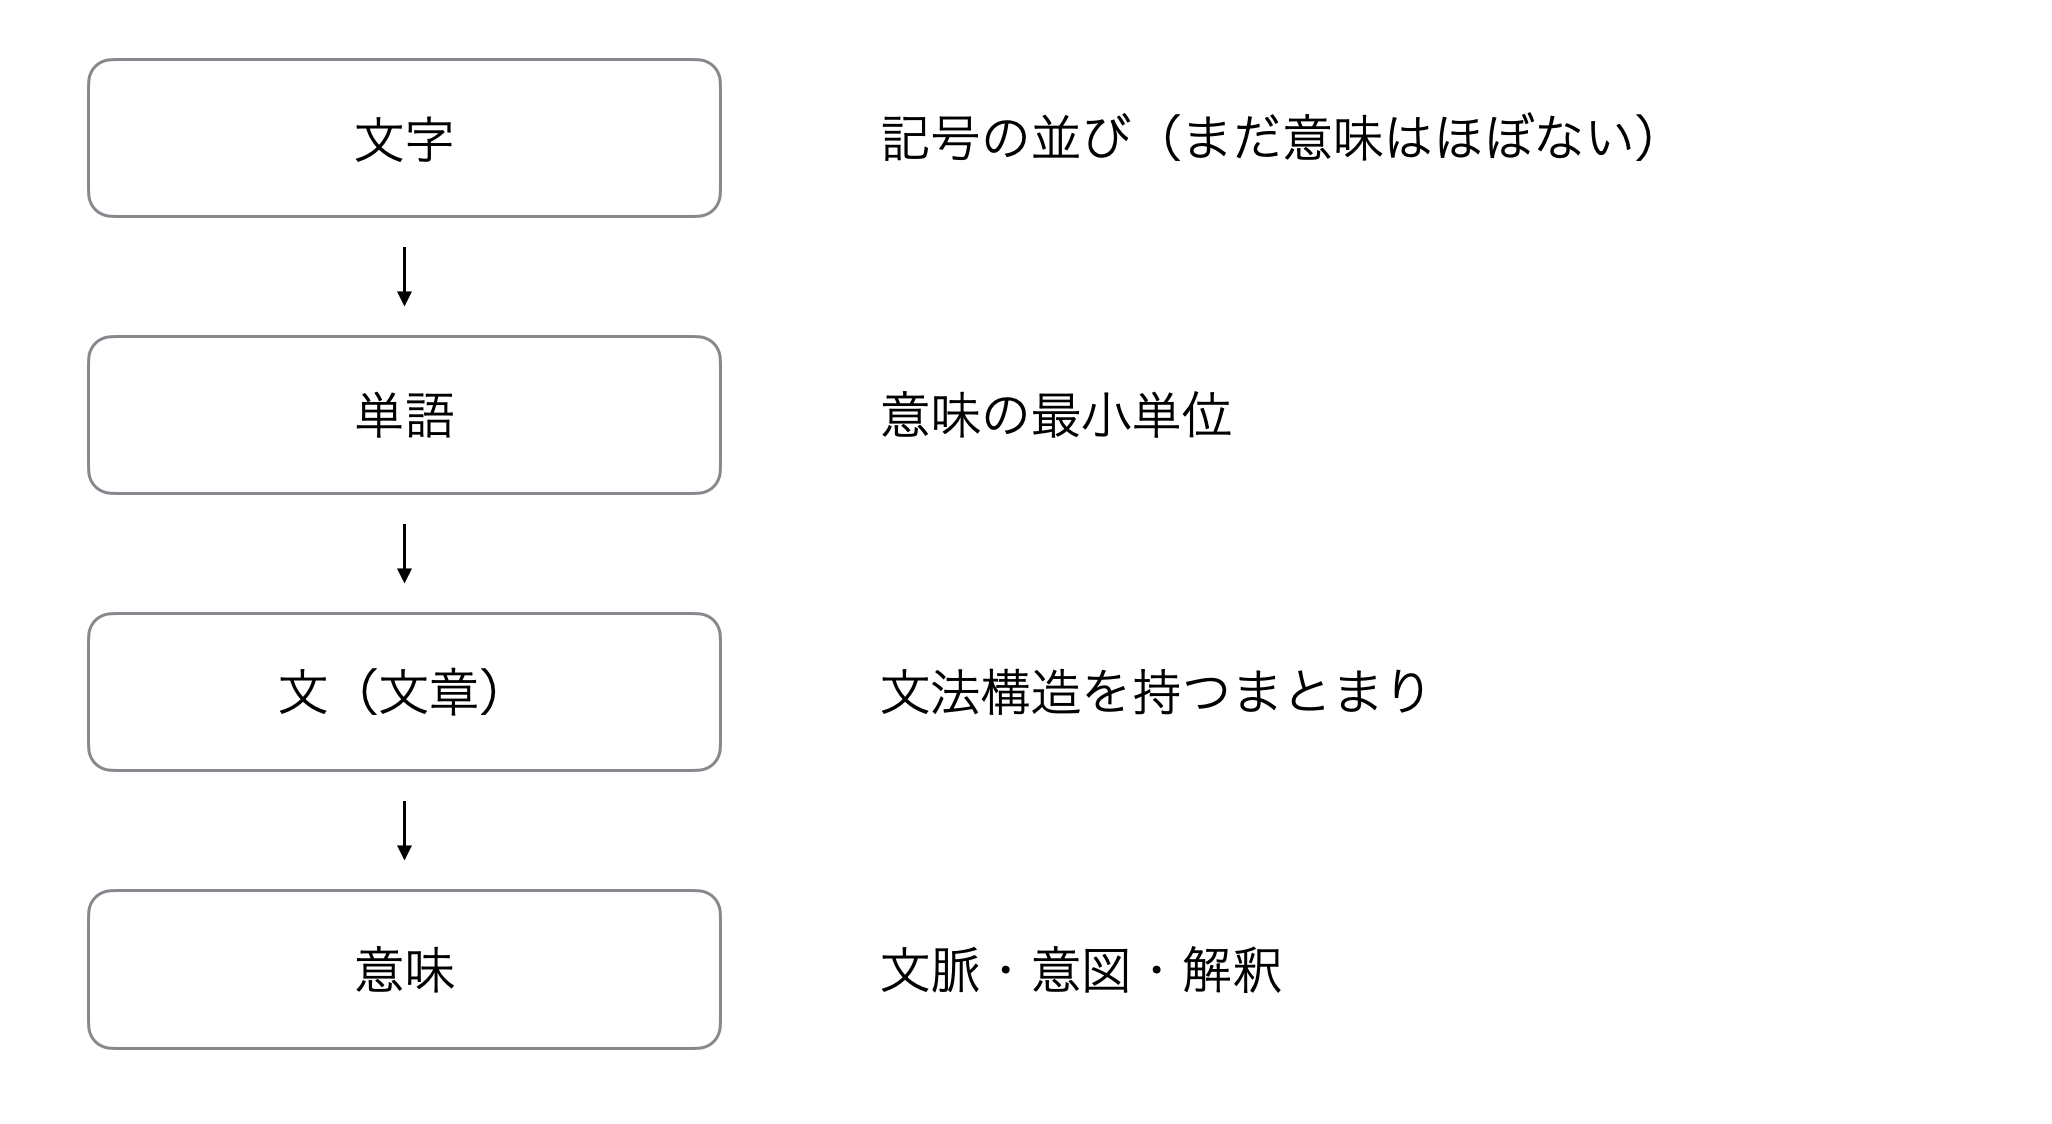
こちらも、もう少し具体的に言うと、こんなかんじです。
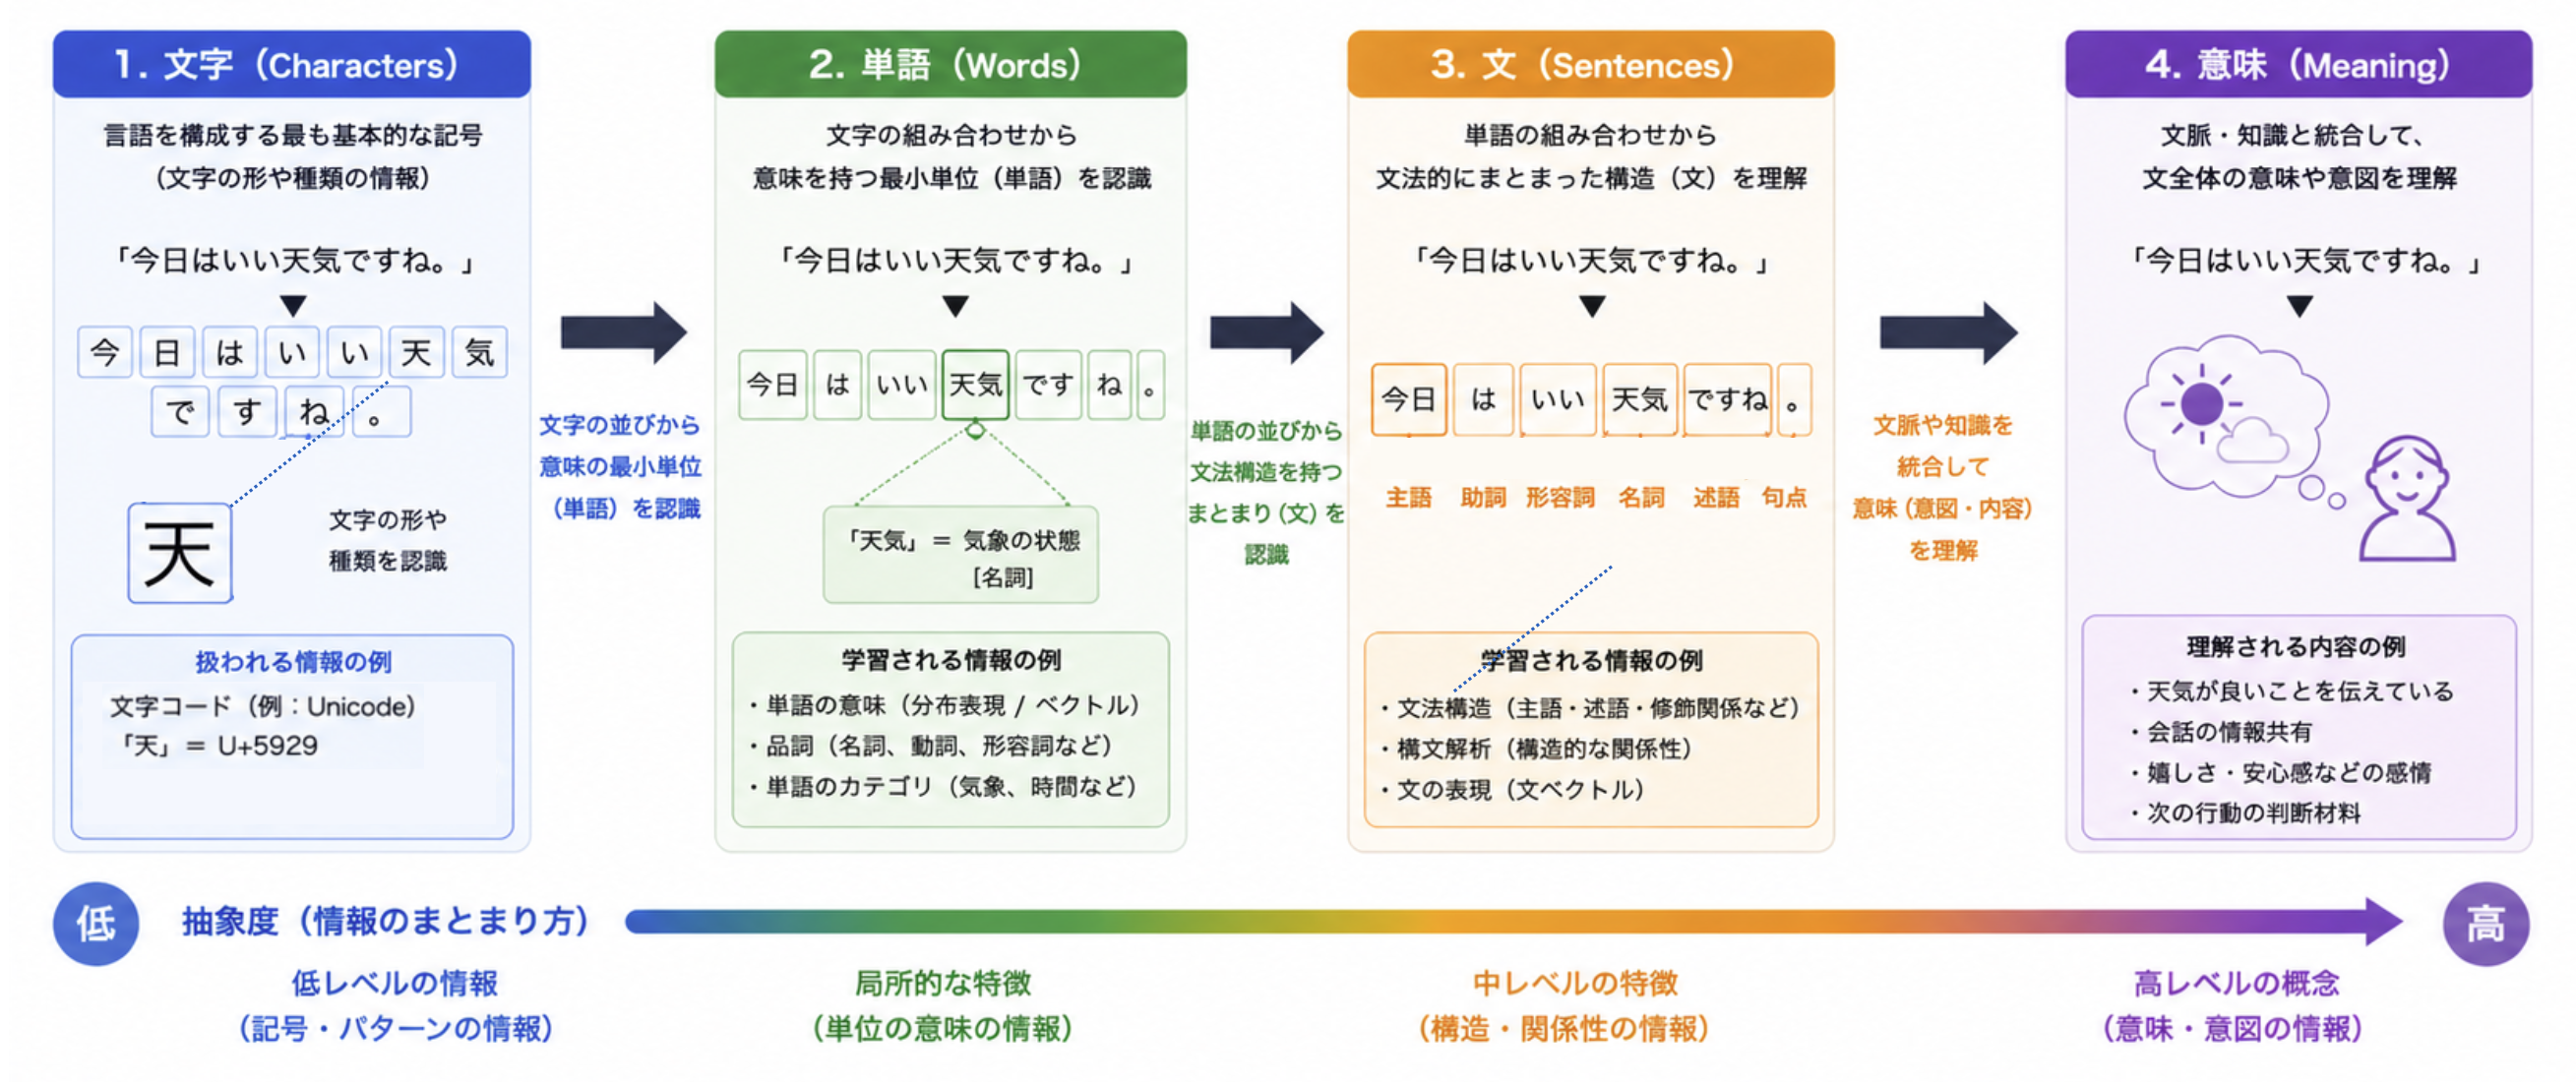
深層学習は、このようなデータに階層的な構造(画像、言語)がある場合に真価を発揮します。
例えば、今日の深層学習とAIにおいて最も重要なアルゴリズムの一つである、「トランスフォーマー」の場合、テキストデータに基づいてモデルを構築する際、テキストの順序や単語、文章間の関係などを考慮に入れ、次の単語を予測します。
しかし、表形式データは異なります。それは単にある現象を説明する変数の集まりに過ぎず、画像やテキストが持つような構造や順序といったものはありません。
表形式データ
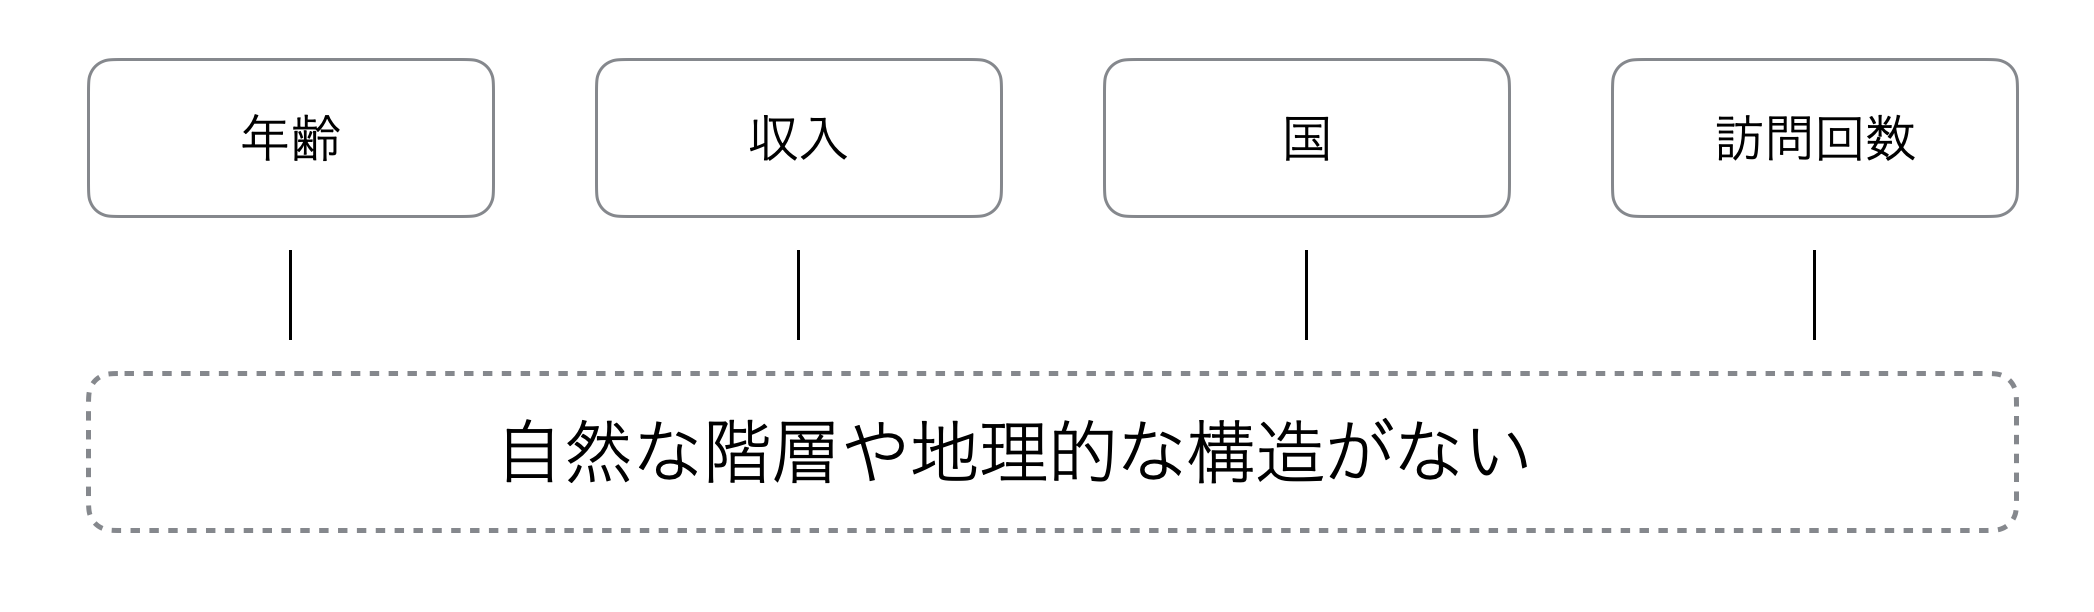
特定の変数における各値は、通常、他の値から独立しています。
そして、この違いこそが、なぜこれまでの機械学習系モデルのほうが深層学習系モデルに比べて優れた結果を出すかの答えを探す際に重要となります。
なぜツリーベースの機械学習モデルはうまく機能するのか
XGBoost、LightGBM、ランダムフォレストなどの機械学習モデルは、ビジネスデータを使って予測モデルを構築するデータサイエンティストやアナリストの間で依然として最もよく使われるアルゴリズムであり、それらは共通のアーキテクチャを共有しています。
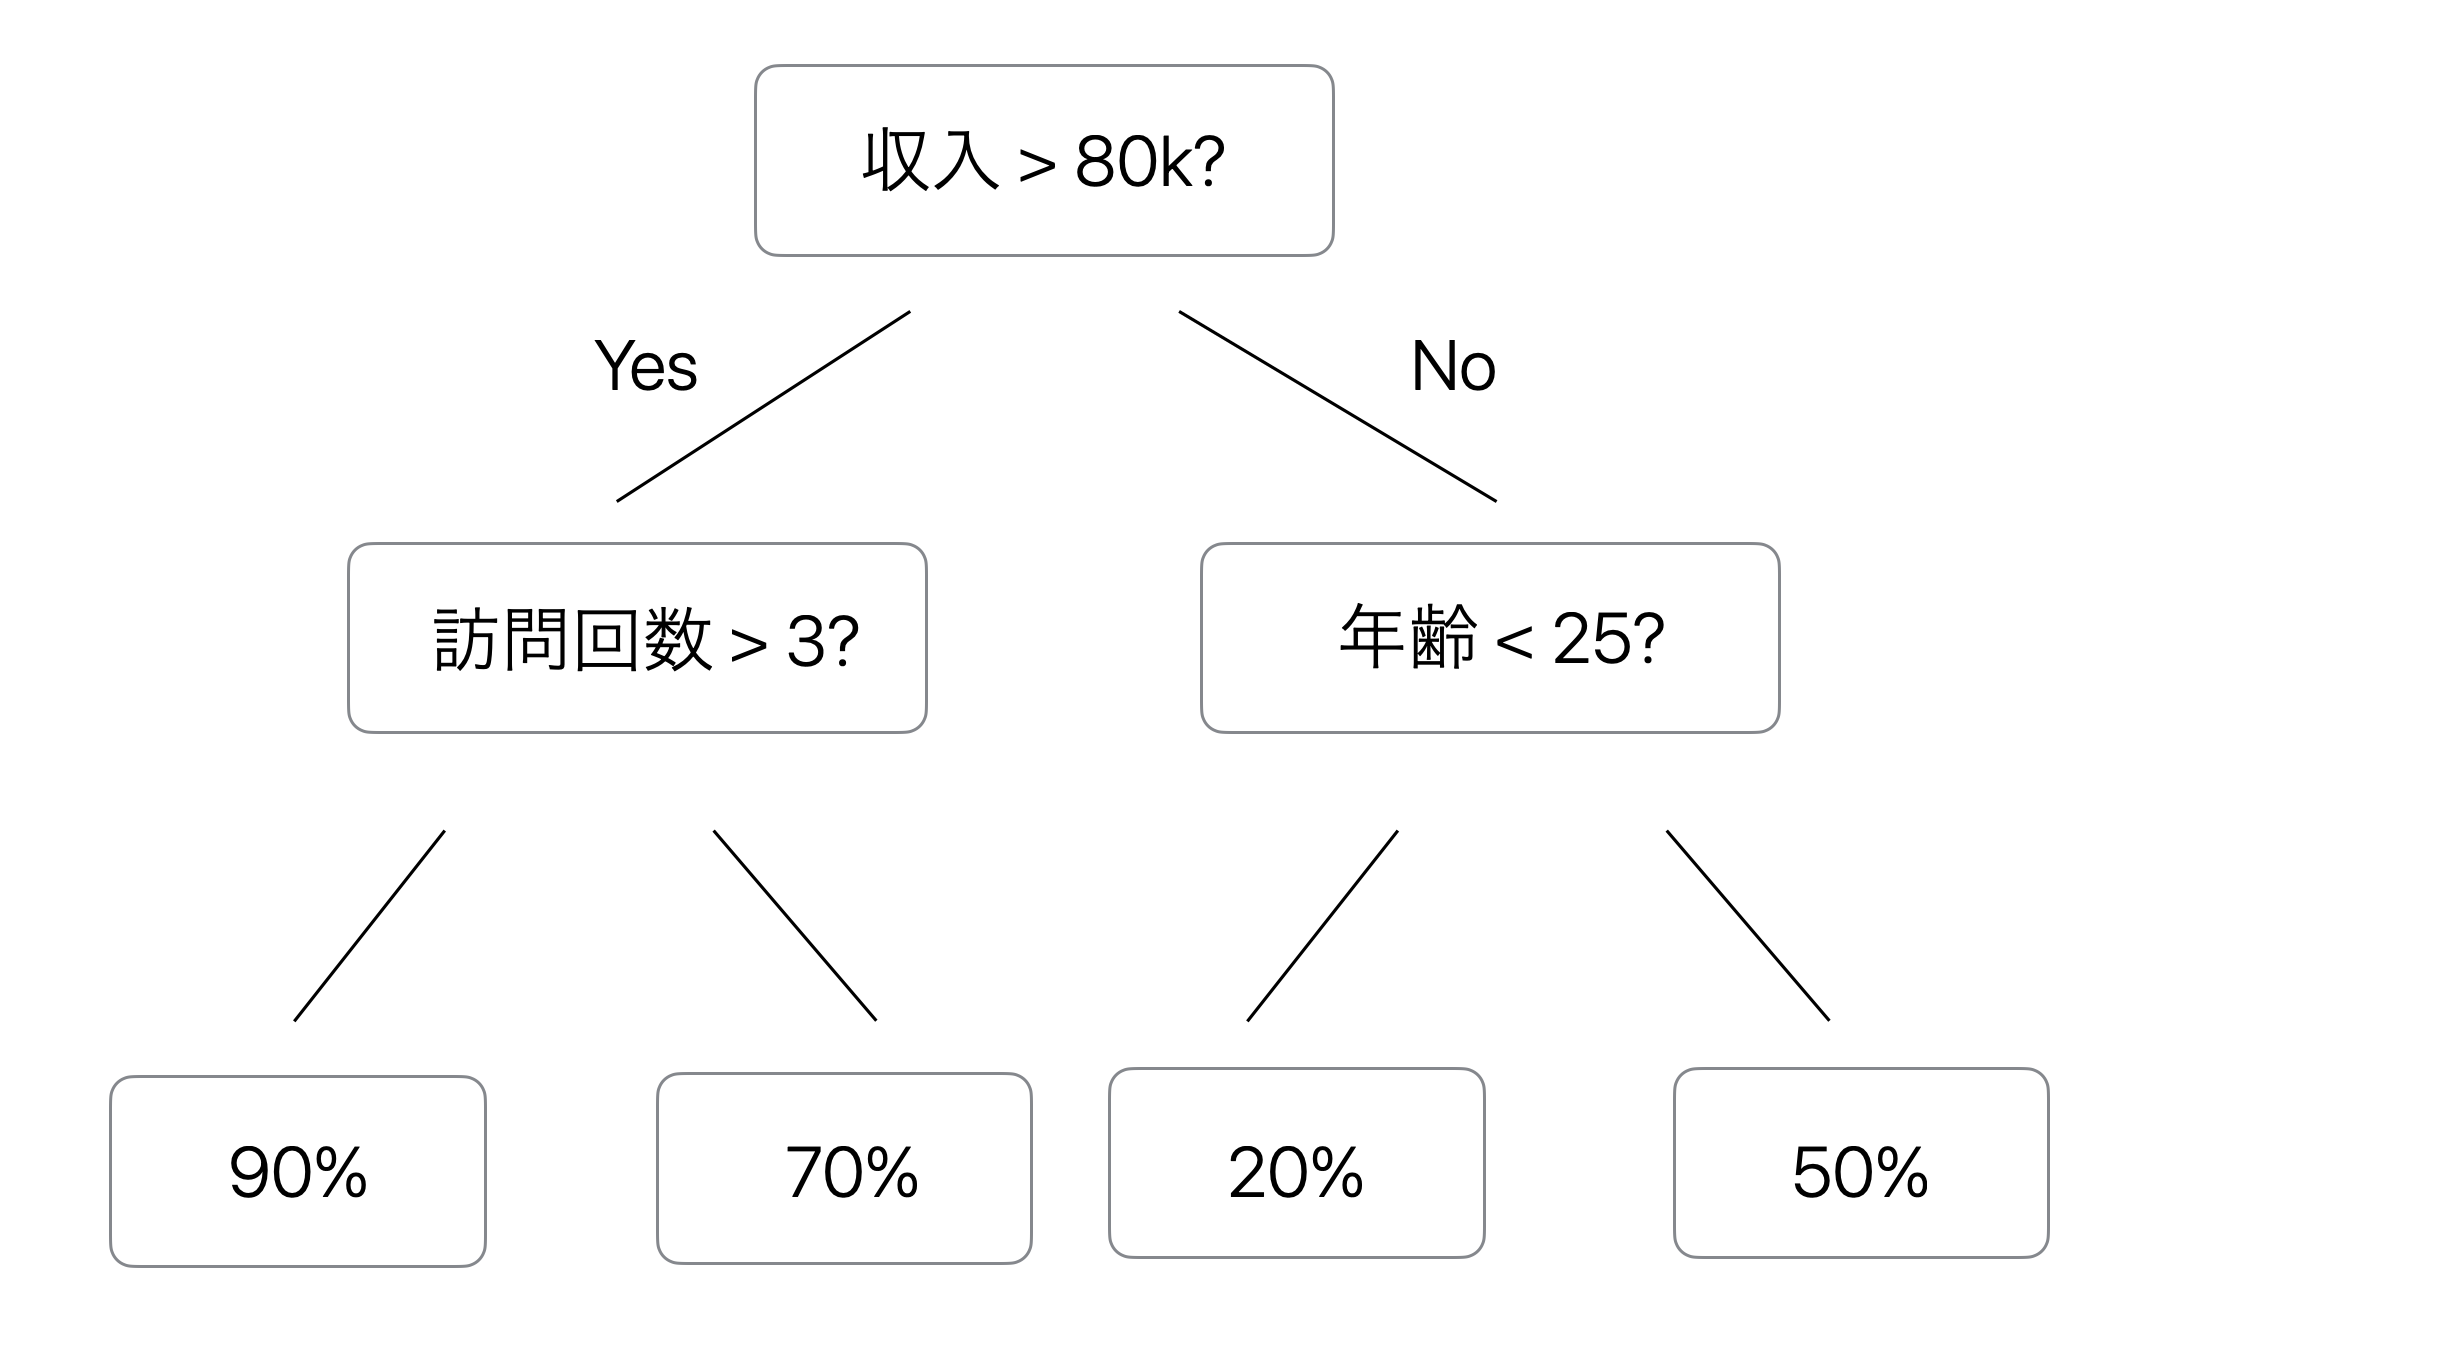
それが一般的にはツリー(木)と言われますが、正式には日本語で「決定木(Decision Trees)」と呼ばれるものです。
決定木は、このタイプのデータにとって非常に自然に感じられる方法で問題にアプローチします。
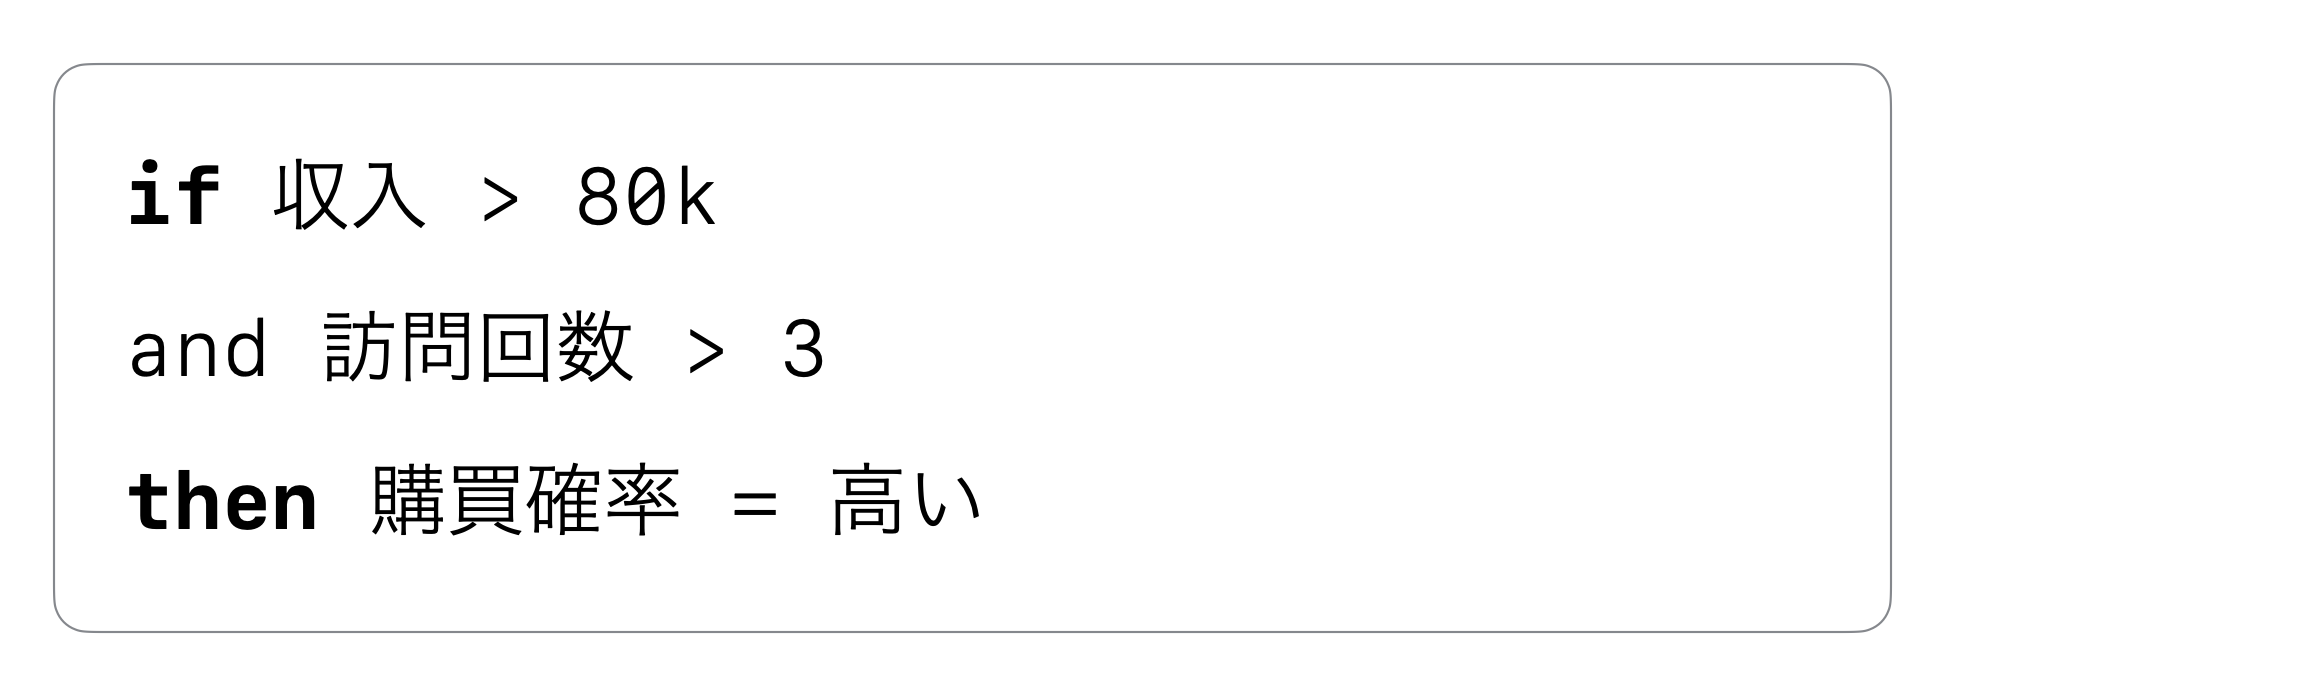
抽象的な表現を学習する代わりに、決定木は「ルール」を学習します。
例えば:
あるいは:
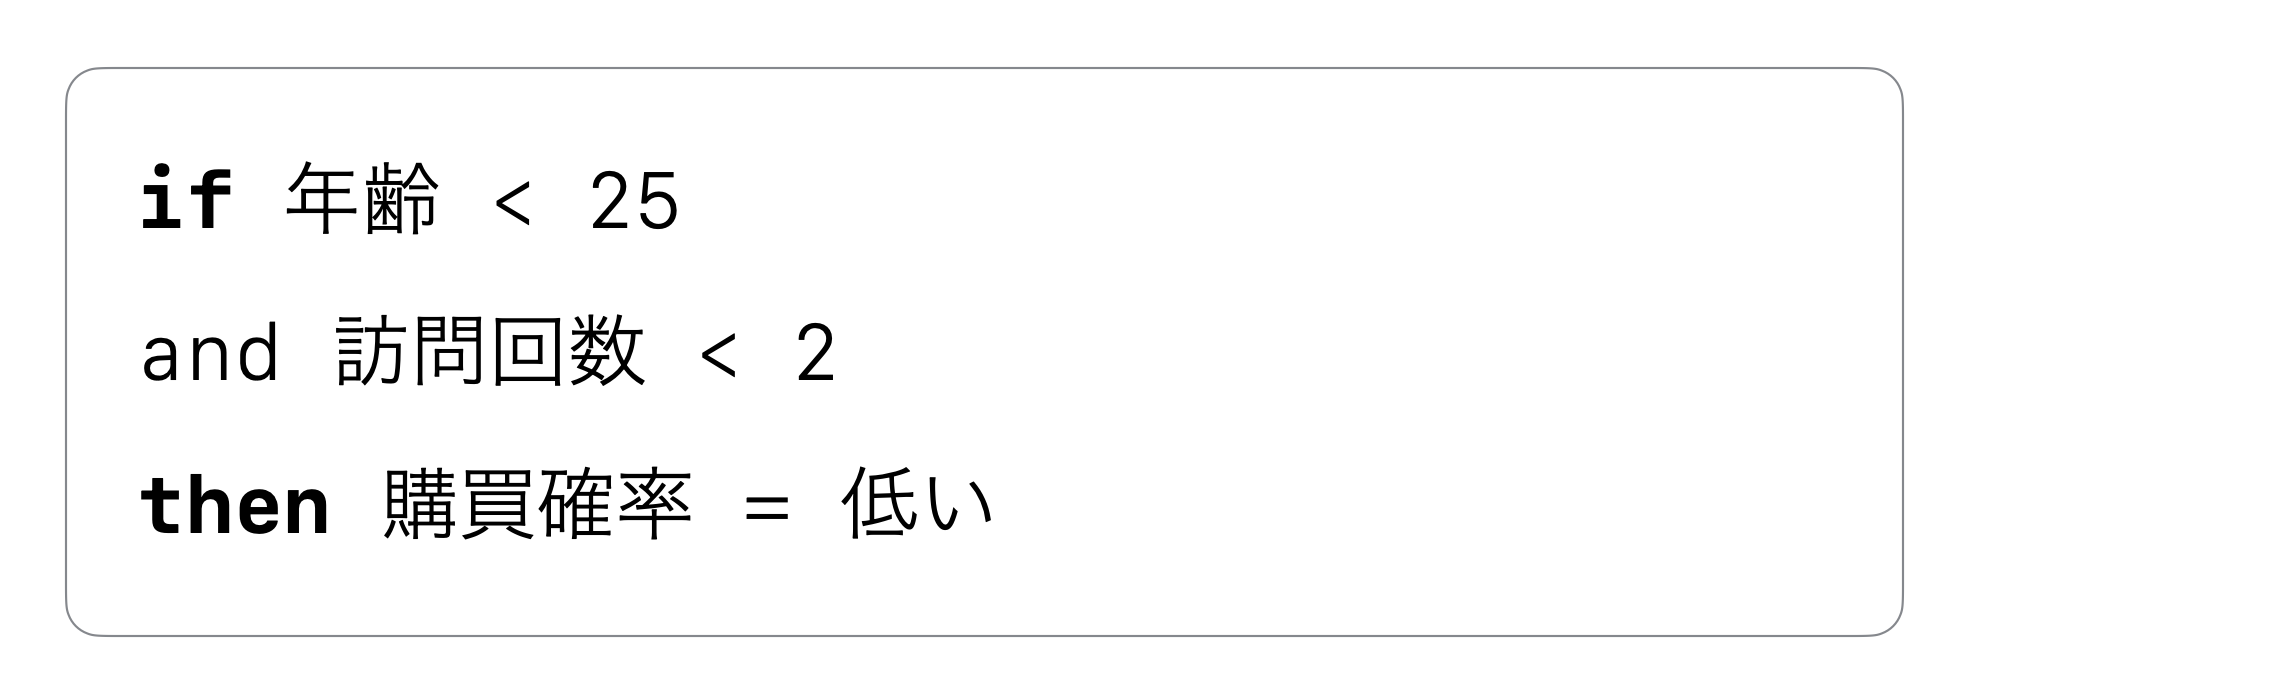
このような条件付きルールは、現実世界のデータセットによく現れるものであり、決定木はそれらを発見するのが得意です。
XGBoostの台頭
2010年代半ば頃に、XGBoostというツリー(決定木)系ファミリーの1つのアルゴリズム登場すると、一気に人気を博しました。
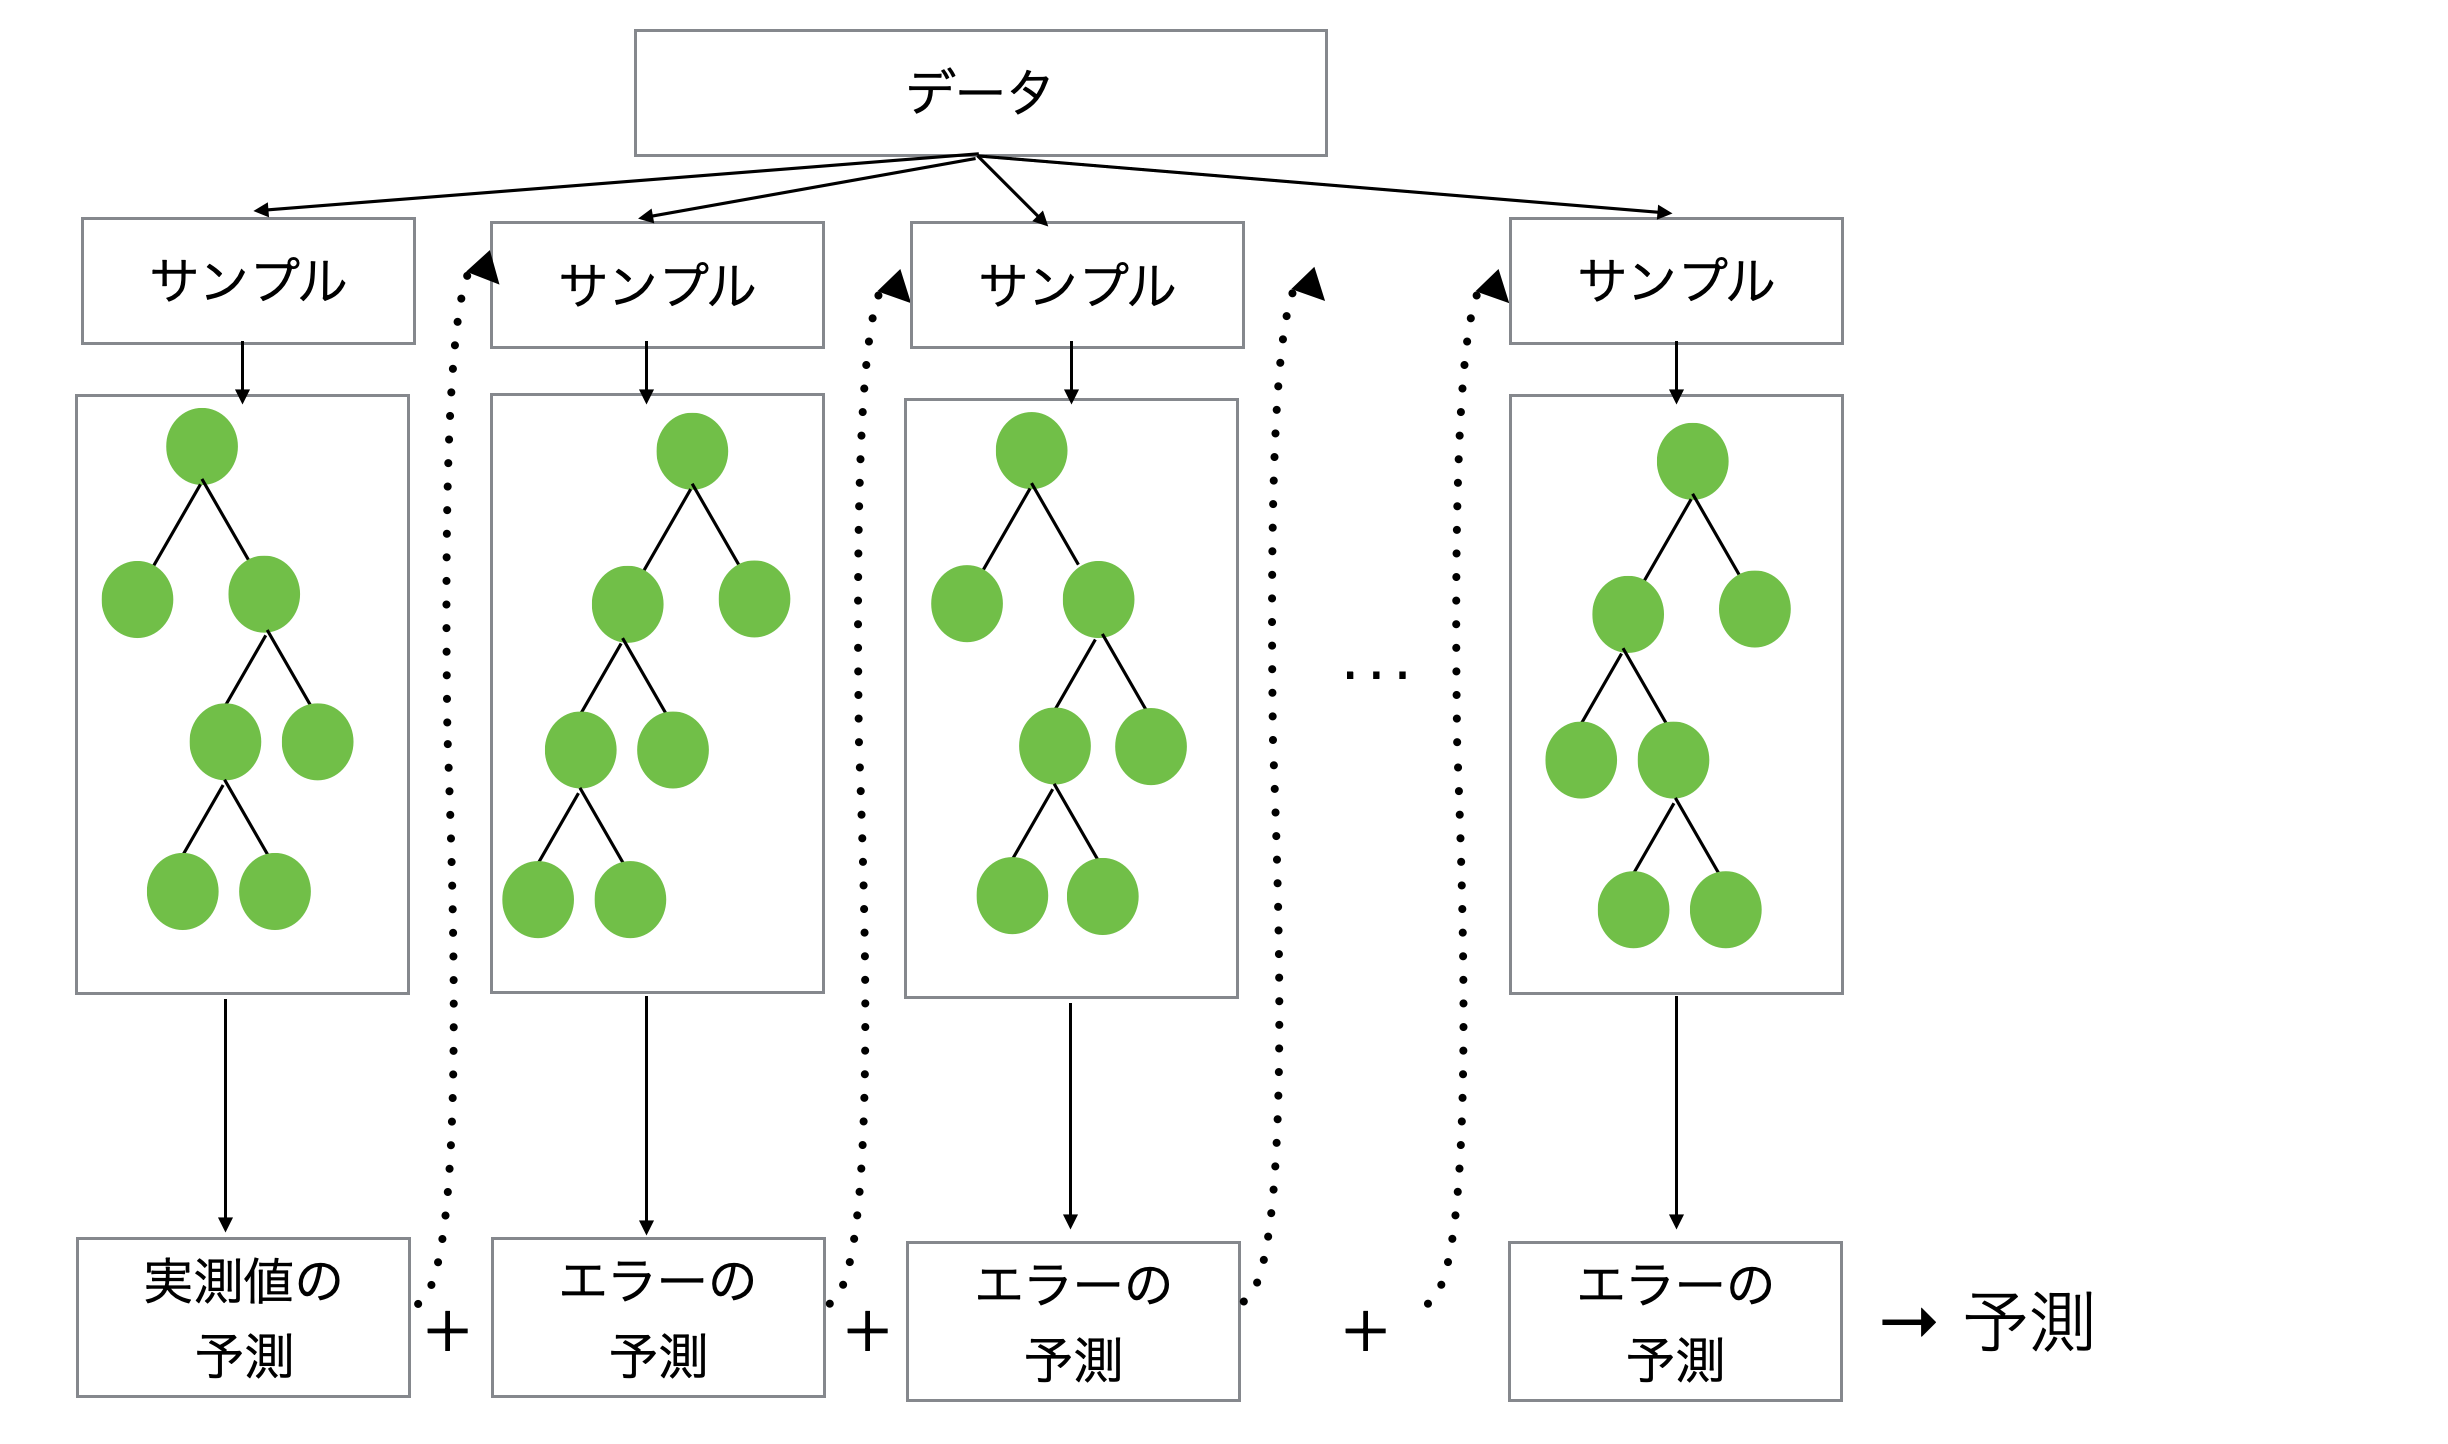
XGBoost は勾配ブースティングを高度に最適化した方法で実装し、表形式データを扱う多くの機械学習を使うデータサイエンティストにとって瞬く間にデフォルトの選択肢となりました。
これはツリーを逐次的に構築し、それぞれのツリーが前のモデルのミスを修正していくというものです。
しかし、データが大きくなるにつれ、モデルのトレーニングに長い時間がかかるという問題がありました。
そこに出てきたのがLightGBMです。
LightGBM の登場
2017年、マイクロソフトの研究者たちが LightGBM と呼ばれる新しいブースティングフレームワークを発表しました。
その目的は、ブースティングを「軽く(Light)」することでした。
LightGBM の「Light」という言葉は、計算量とメモリ使用量が軽量であることを指しています。
これを実現するために、いくつかのスマートな実装が行われました。例えば、「リーフ単位(leaf-wise)」でツリーを成長させる手法です。これは損失が最も減少する場所でツリーを成長させ、モデルの最も情報量の多い部分に計算を集中させることができます。
レベル単位 (XGBoost)
        Root
       /    \
      A      B
     / \    / \
    C   D  E   F
リーフ単位 (LightGBM)
        Root
       /    \
      A      B
     / \
    C   D
   /
  E
他にも以下のような手法を追加することで、予測精度の品質を落とすことなくモデル構築にかかる時間を劇的に削減することに成功しました。
- 数値をヒストグラムに変換し、分割の評価回数を減らす
- 勾配の大きい行を優先する「GOSS」を採用
- スパース(空きが多い)変数の値を圧縮する EFB(Exclusive Feature Bundling) を採用
多くの変数(特徴量)やハイパーパラメータをチューニングして機械学習モデルの実験を行う人々にとって、このスピードの向上は大きなインパクトを与えるものでした。
LightGBMについては、別の紹介記事で詳しく書いているので、興味のある方はぜひご参照ください。
なぜ深層学習は苦戦することが多いのか?
ところで、ビジネスでよく使われる表形式のデータに対して、深層学習のアルゴリズムを使って予測モデルの精度を上げようとする試みは終わったわけではありません。実際、これまでも多くの研究者がニューラルネットワークを表形式データセットに適用しようと試みてきました。
しかし、非常に多くの場合、XGBoost や LightGBM といったツリー(決定木)ベースのモデルの方が依然として優れたパフォーマンスを示しました。
その理由は驚くほど単純です。
深層学習は、データに豊かな内部構造が含まれている場合に優れています。例えば、画像であれば空間的なパターン、言語であれば文法的なパターンといった具合です
しかし、表形式データには通常、そういったパターンは存在しません。
代わりに、表形式データには以下のようなものが含まれることが多いです。
- 多様な変数の混在
- エンジニアリングされた特徴量(元の変数に基づいて人工的に作成された追加変数)
- 疎なカテゴリ・エンコーディング(ワンホットエンコーディング)
- 非線形な特徴量間の相互作用
ツリー(決定木)ベースのモデルは、このような種類のパターンを発見するのに、より適しているのです。
ビジネスの現場では
多くの現実世界の機械学習プロジェクトにおいて、ワークフローはしばしば次のようになります。
- ベースラインモデルを構築する。
- ツリー(決定木)ベースのモデルを試す。
- 特徴量エンジニアリングとパラメータチューニングを通じてモデルを改善する。
そして、最終的に最も優れたパフォーマンスを発揮するモデルは、XGBoost や LightGBM などのブースティングアルゴリズムに基づいていることが非常に多いのです。
これらのアルゴリズムは、表形式データに対して予測モデルを作り、実際に予測する際には信頼できるツールとなったのでした。
これらのモデルを自分で試す
Exploratoryを作った理由の一つは、データサイエンスにおけるさまざまなツールを使いやすくすることであり、機械学習モデルによる予測モデルの構築もその一つです。
Exploratory では、以下のようなツリー(決定木)ベースのモデルをトレーニングできます。
- 決定木
- ランダムフォレスト
- XGBoost
- LightGBM
これらをインタラクティブなインターフェースから直接実行できます。
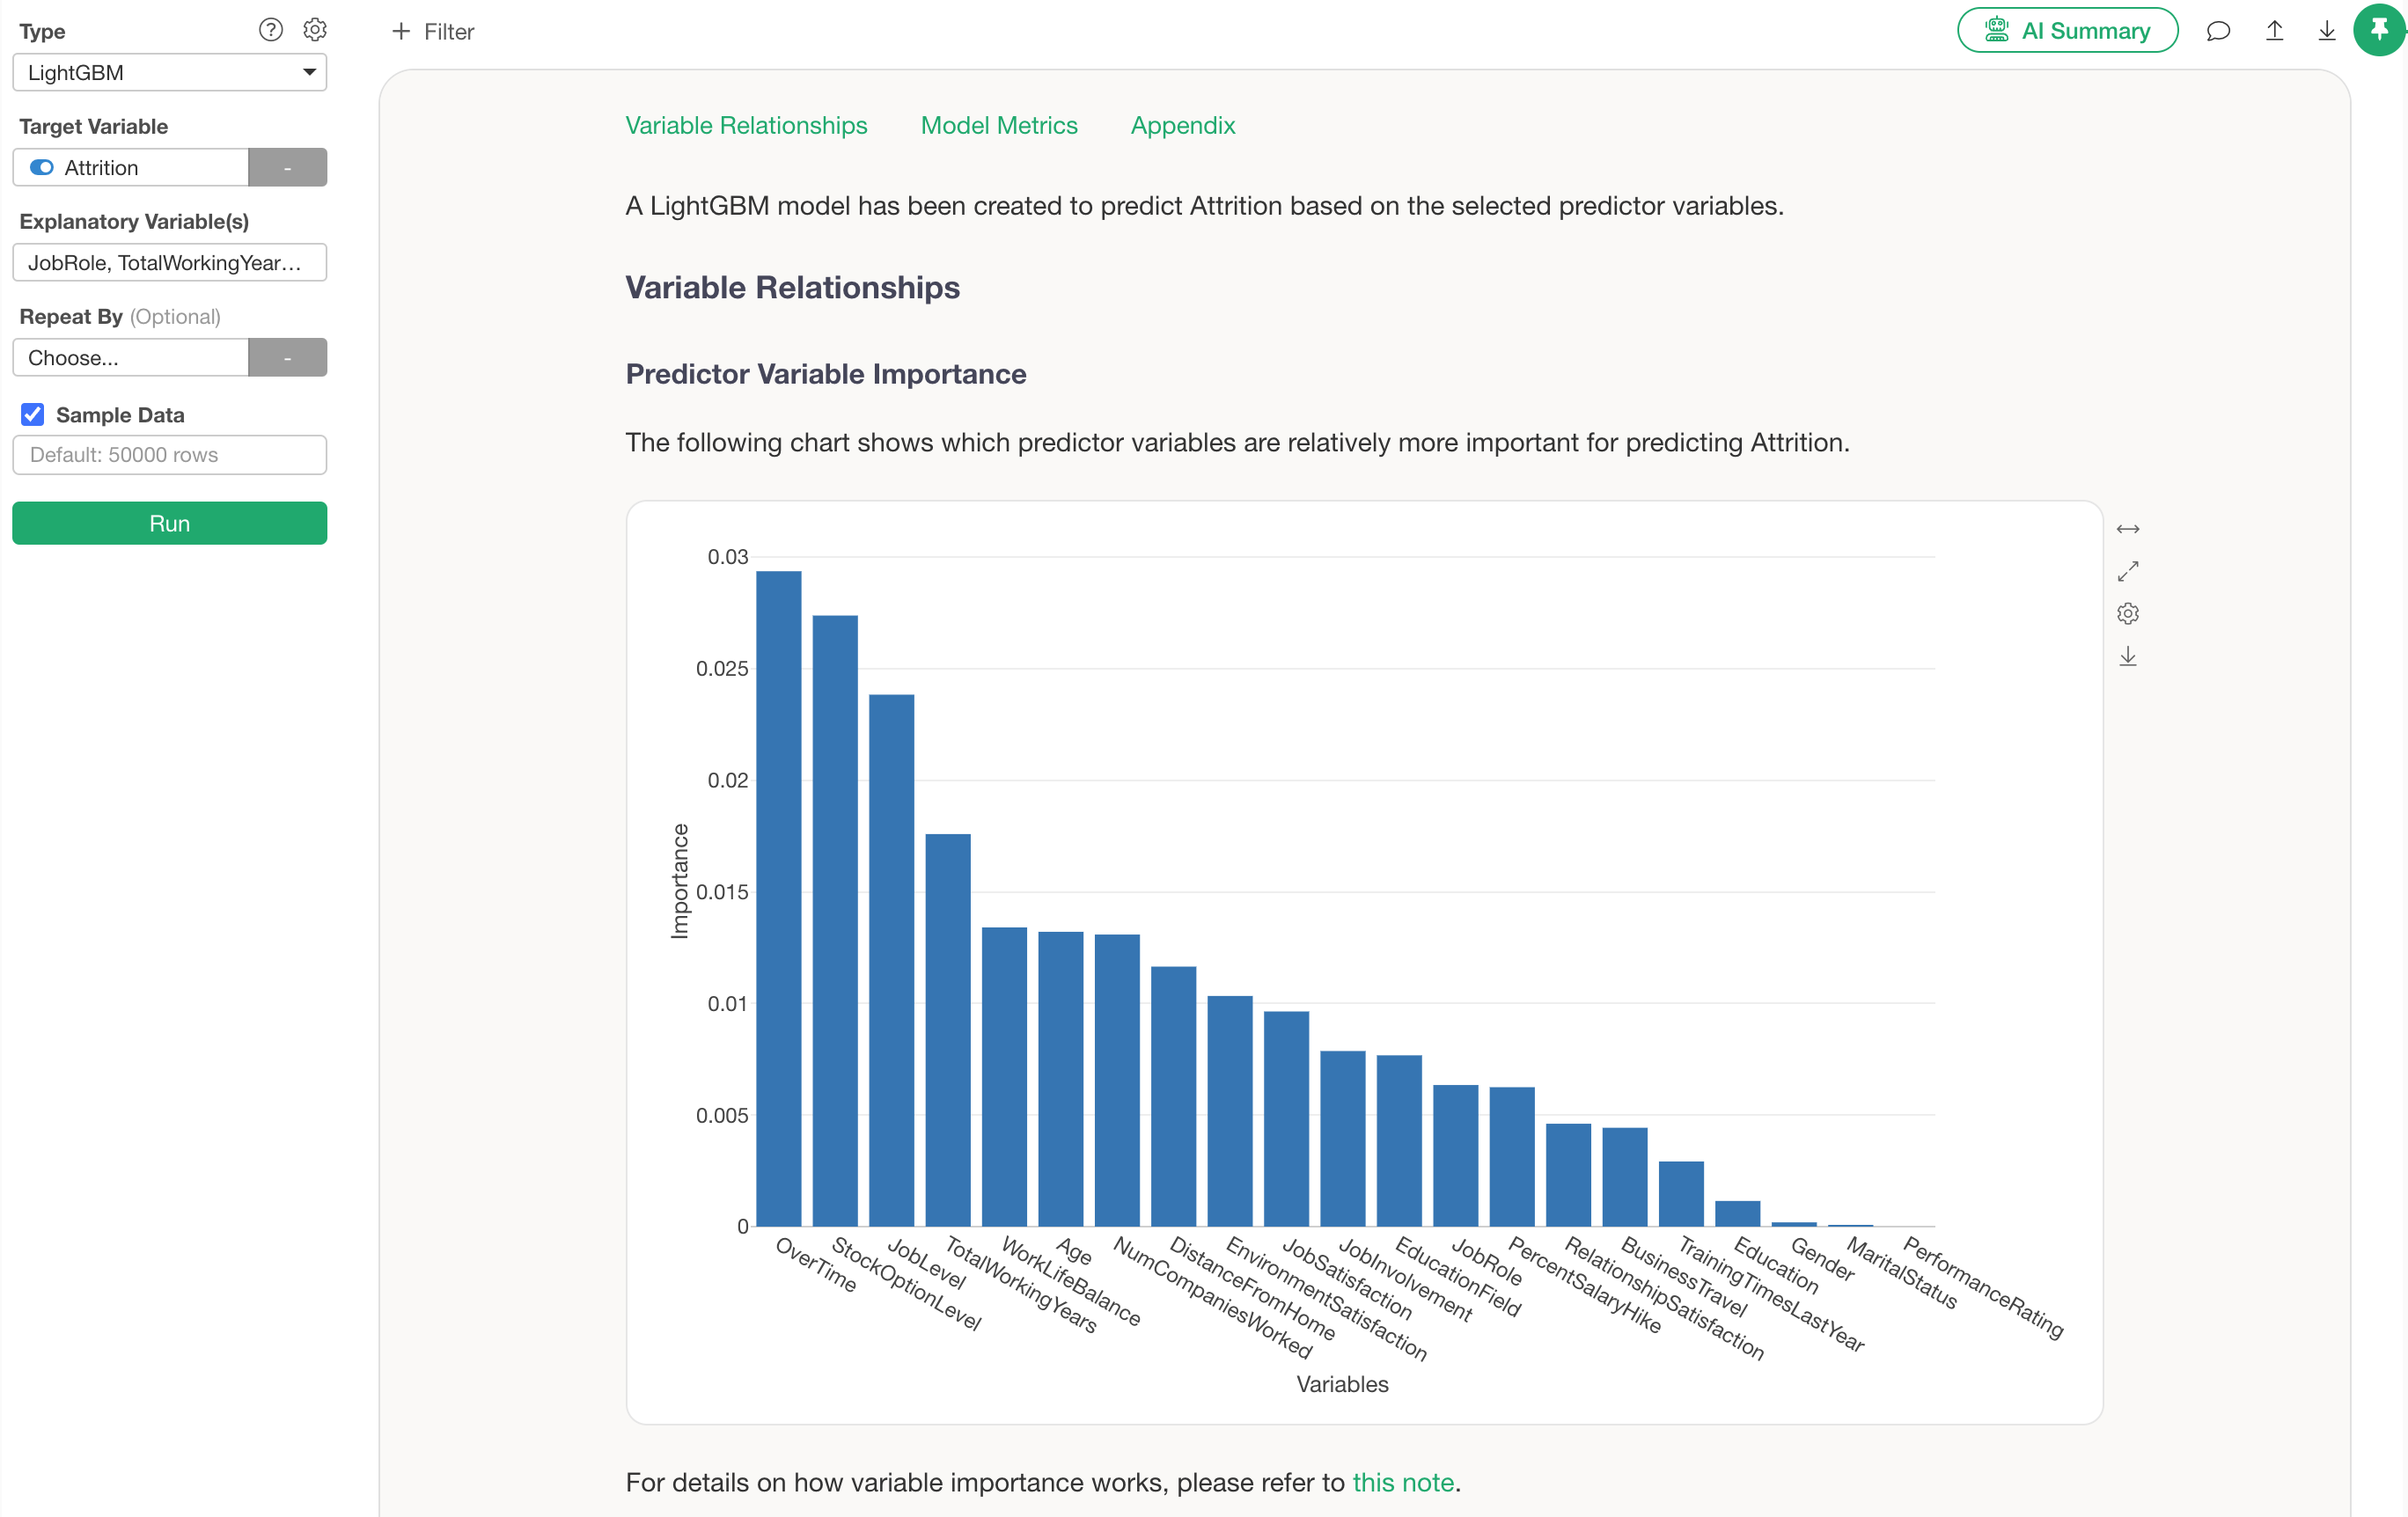
LightGBM の使用方法の詳細については、こちらのハウツーノートをご覧ください。
顧客行動、購買履歴、アクセスログ、人事、財務、などといった表形式データに対して精度の良い予測モデルを作たいという場合には、こうしたモデルを試してみることをおすすめします!
最後に
結局のところ、深層学習系モデルの登場とその後の急激な進化は従来の機械学習アルゴリズムを排除することはありませんでした。
むしろ、重要なことを明確にしました。
データの種類が異なれば、必要なツールも異なるということです。
画像と言語については、ご存知の通り深層学習系モデルが支配しています。
しかし、ビジネスで使われることが多い表形式データについては、XGBoost や LightGBM のようなツリーベースのアルゴリズムが、依然として利用可能な最も強力な手法の一つであり続けています。
私が XGBoost や LightGBM のようなブースティングアルゴリズムを高く評価している点の一つは、それらが、精度の高い予測モデルの構築という点でとても実用的であることです。
これらのモデルを作るのに、大規模なインフラや複雑なニューラルネットワークのアーキテクチャは必要ありません。手元のデータから始め、必要に応じていくつかの特徴量(変数)を構築し、モデルに有用なパターンを発見させるだけです。
そして多くの場合、その結果は驚くほど素晴らしいものです!
Exploratoryでは、ランダムフォレスト、XGBoost、LightGBM などのモデルをインタラクティブなインターフェースから直接トレーニングし、データセットに対するパフォーマンスを比較できます。
これらのモデルの強みを理解する最も簡単な方法は、自分のデータでそれらがどのように機能するかを実際に見てみることです。
Exploratory をダウンロード
最新バージョンの Exploratory で、XGBoost、LightGBM、ランダムフォレスト、その他のモデルを今すぐ使い始めることができます。
👉 Exploratory をダウンロード
https://exploratory.io/download
まだアカウントをお持ちでない場合は、こちらからサインアップして 30日間の無料トライアル を開始してください。
トライアル期間が終了していても、新機能を試してみたい場合は、最新バージョンを起動して「トライアルを延長(Extend Trial)」オプションを使用してください。
ご質問やフィードバックがございましたら、お気軽に kan@exploratory.io までご連絡ください。
皆様が Exploratory を使ってどのようにデータからインサイトを発見されているか、ぜひお聞かせください。
西田 勘
CEO, Exploratory